Kort fortalt: Når et salgsteam deler skills i Claude, er det Claude, der vælger, hvilken skill en forespørgsel skal bruge, ud fra navn og beskrivelse. Det ser ingen. Jeg fik Claude til at bygge et opdigtet team med syv salgsskills og 40 forespørgsler, som sælgere skriver dem. Claude hentede den forventede skill i 120 af 120 kørsler. Med tyve skills, der overlapper, var det 117 af 120. Så skrev Claude beskrivelsen om på den ene skill, der bommede. Bommen blev rettet, og to forespørgsler, der ramte rigtigt før, gik nu til den forkerte skill i hver kørsel.
Længere nede i artiklen er der en interaktiv demo, hvor du ser hver forespørgsel lande i den skill, Claude valgte, og hvor du selv kan åbne hver af dem og se alle tre kørsler.

Hvorfor skal en salgschef vide, hvilken skill Claude henter?
En skill er teamets egen opskrift: sådan forbereder vi et første møde, sådan skriver vi et tilbud, sådan svarer vi på en indvending. Den virker kun, hvis Claude henter den. Skriver en sælger „kunden siger vi er for dyre, hvad svarer jeg“, skal Claude finde teamets skill til indvendinger og ikke bare svare med sine egne ord.
Henter Claude den forkerte skill, får sælgeren et tilbud, der er skrevet som en prisudregning, eller en opfølgning uden teamets skabelon. Henter den ingen, får sælgeren et almindeligt svar. Der kommer ingen fejlmeddelelse. Sælgeren tror, at teamets opskrift blev brugt, og salgschefen tror, at udrulningen virker.

Hvordan bruger jeg Claude i min virksomhed med skills, som hele teamet deler?
Skriv én skill pr. opgave, som teamet gentager, og giv den en beskrivelse, der siger, hvornår den skal bruges, med eksempler i de ord, dine sælgere faktisk skriver. Lav samtidig en liste med 30 til 50 rigtige forespørgsler, hver med den skill, der burde blive hentet. Kør listen, før du ruller skills ud, og igen, hver gang en beskrivelse ændrer sig.

Syv skills ramte rigtigt. Tyve begyndte at overlappe
Det første resultat overraskede mig. Hver af de syv skills havde én enkel sætning som beskrivelse, og de 40 forespørgsler var korte og rodede, på dansk og engelsk. Alligevel ramte Claude rigtigt i 120 af 120 kørsler. Et lille bibliotek med skills, der laver tydeligt forskellige ting, klarer sig fint med beskrivelser i første udkast.
Så voksede biblioteket til tyve skills, og flere af de nye lå tæt op ad de gamle: en skill til opfølgningsmails ved siden af den til referater efter møder, pris-skillen ved siden af tilbudsskillen. Facit var sat, før kørslen startede, og for fire forespørgsler godtog facit to skills, fordi en salgschef ville være tilfreds med begge. Én af dem, en forespørgsel om et prisdokument, gik til pris-skillen hver gang og tæller som rigtig.
Resultatet blev 117 af 120. Den eneste bom var „hvad er 15% rabat på 48.000 kr“, som hentede pris-skillen, hvor facit sagde ingen skill. Det facit blev sat, før pris-skillen fandtes, og man kan godt mene, at pris-skillen burde tage den.
Claude fik kun den ene bom at se og skrev beskrivelsen om på netop pris-skillen. Den nye beskrivelse siger, at en hurtig enkeltstående udregning ikke hører til der, og nu hentede udregningen ingen skill i nogen af de tre kørsler. Men den nye beskrivelse kalder også et prisoverslag for „et tilbud“, med et dansk eksempel: „lav et tilbud på 20 licenser“. To forespørgsler, „de vil have et tilbud inden fredag, kan du starte på det? noter vedhæftet“ og „byg et tilbud til Sund Klinik ud fra noterne, pris 95.000 kr“, havde ramt tilbudsskillen i alle tre kørsler. Efter rettelsen gik de til pris-skillen i alle tre. Formentlig fordi tilbud på dansk både er et forslag og en pris. Det er én omskrivning og ikke et bevis på årsagen.
For teamet betyder det to ting. Risikoen kommer, når biblioteket vokser, og nye skills lægger sig op ad de gamle. Og retter du én beskrivelse, kan det flytte forespørgsler fra naboen, uden at nogen opdager det. Den, der ejer teamets skills, skal derfor have en fast liste med forespørgsler og køre hele listen efter hver ændring. For de seksten forespørgsler, Claude aldrig havde set, faldt resultatet fra 45 til 42 af 48 efter rettelsen. Et nordisk team skal også tænke på ord, der betyder to ting på dansk, når beskrivelserne er skrevet på engelsk.

Kan man stole på tallene?
Teamet, skillsene og forespørgslerne er opdigtede, og facit er sat af den, der byggede testen. Hver forespørgsel gik til Claude Sonnet 5.5 tre gange med hele biblioteket som eneste værktøj, og den skill, Claude kaldte først, tæller som valget. Det er min efterligning af, hvordan en skill bliver valgt, og ikke Claude Codes eller claude.ai's egen mekanisme. Valget sker ud fra navn og beskrivelse, som Anthropics dokumentation om skills beskriver. Alle tal er regnet ud igen fra de gemte kørsler. Tre kørsler pr. forespørgsel er et lille udsnit, så „3 af 3“ betyder stabilt i tre forsøg. En separat gennemgang ledte efter påstande, der ikke holdt, og de forbehold, den fandt, står her i teksten.
Prøv det: lad demoen spille færdig, og tryk så på en hvilken som helst forespørgsel for at se, hvilken skill Claude valgte i hver af de tre kørsler. Med „Kørsel 1, 2, 3“ skifter du mellem dem, og beskrivelserne står på dansk med den engelske original et tryk væk.

Kør testen på dine egne skills
Du får testværktøjet gratis på mail: scriptet, de tyve salgsskills, de 56 forespørgsler med facit, mine scorede kørsler og en vejledning på dansk og engelsk. Hent testværktøjet til Claude-skills.
Sådan bruger du det: Skriv 30 til 50 forespørgsler, som dine sælgere faktisk skriver, uden kundenavne, og sæt den skill på, der burde blive hentet. Peg værktøjet på din mappe med skills, og kør listen med din egen API-nøgle. Du får et resultat og hver bom med de tre valg. Ret beskrivelsen, og kør så hele listen igen, ikke kun den forespørgsel, der bommede.
Det kan testværktøjet ikke. Det efterligner, hvordan en skill bliver valgt, men det er ikke en bestemt apps egen mekanisme, så et resultat siger, om en beskrivelse styrer Claude godt. Facit er dit, og er det til diskussion, er tallet det også. Et svar uden et kald til en skill tæller som ingen skill, også når Claude stillede et spørgsmål i stedet; svaret bliver gemt, så du kan se det. Og forespørgslerne bliver sendt til Claude API, så brug eksempler uden kundedata.

Interne AI værktøjer, som sælgerne kan stole på
Jeg er AI-konsulent i København og bygger interne AI værktøjer på Claude til nordiske B2B-salgsteams. Når jeg ruller skills ud for et team, skriver vi beskrivelserne med de ord, dine sælgere bruger, på begge sprog, og vi bygger listen med forespørgsler sammen, så den kører igen, hver gang biblioteket ændrer sig. Det er den del af implementering af AI, der gør AI agenter til noget, salgschefen kan stå inde for. Se, hvordan jeg bygger interne AI værktøjer.
Skills har også en sikkerhedsside. Læs hvad Anthropics scanning af skills dækker, og hvad den ikke dækker.
FAQ
Ofte stillede spørgsmål
En mappe med en SKILL.md-fil, der har et navn, en beskrivelse og en fremgangsmåde. Claude læser navn og beskrivelse og henter først resten, når den vælger skillen.
Ud fra navn og beskrivelse. Derfor er det beskrivelsen, du styrer med: den skal sige, hvornår skillen skal bruges, og gerne vise eksempler i dine sælgeres egne ord.
Testen viste ingen grænse ved syv, men overlappet begyndte at koste, da biblioteket voksede til tyve. Det handler mindre om antallet og mere om, hvor tæt skillsene ligger på hinanden.
Skriv dem på det sprog, teamet arbejder på, og tag eksempler med på begge sprog, hvis sælgerne skriver begge. Pas på ord, der betyder to ting, som tilbud.
Nej. Teamet og forespørgslerne er opdigtede, og facit er sat af den, der byggede testen. Kør værktøjet på dine egne forespørgsler for at få dine egne tal.
Ét kald til Claude API pr. forespørgsel pr. kørsel. 56 forespørgsler med tre kørsler er 168 kald på din egen API-nøgle.
Ja. Jeg skriver beskrivelserne med dit team og bygger listen med forespørgsler, så den kører, hver gang en skill ændrer sig.
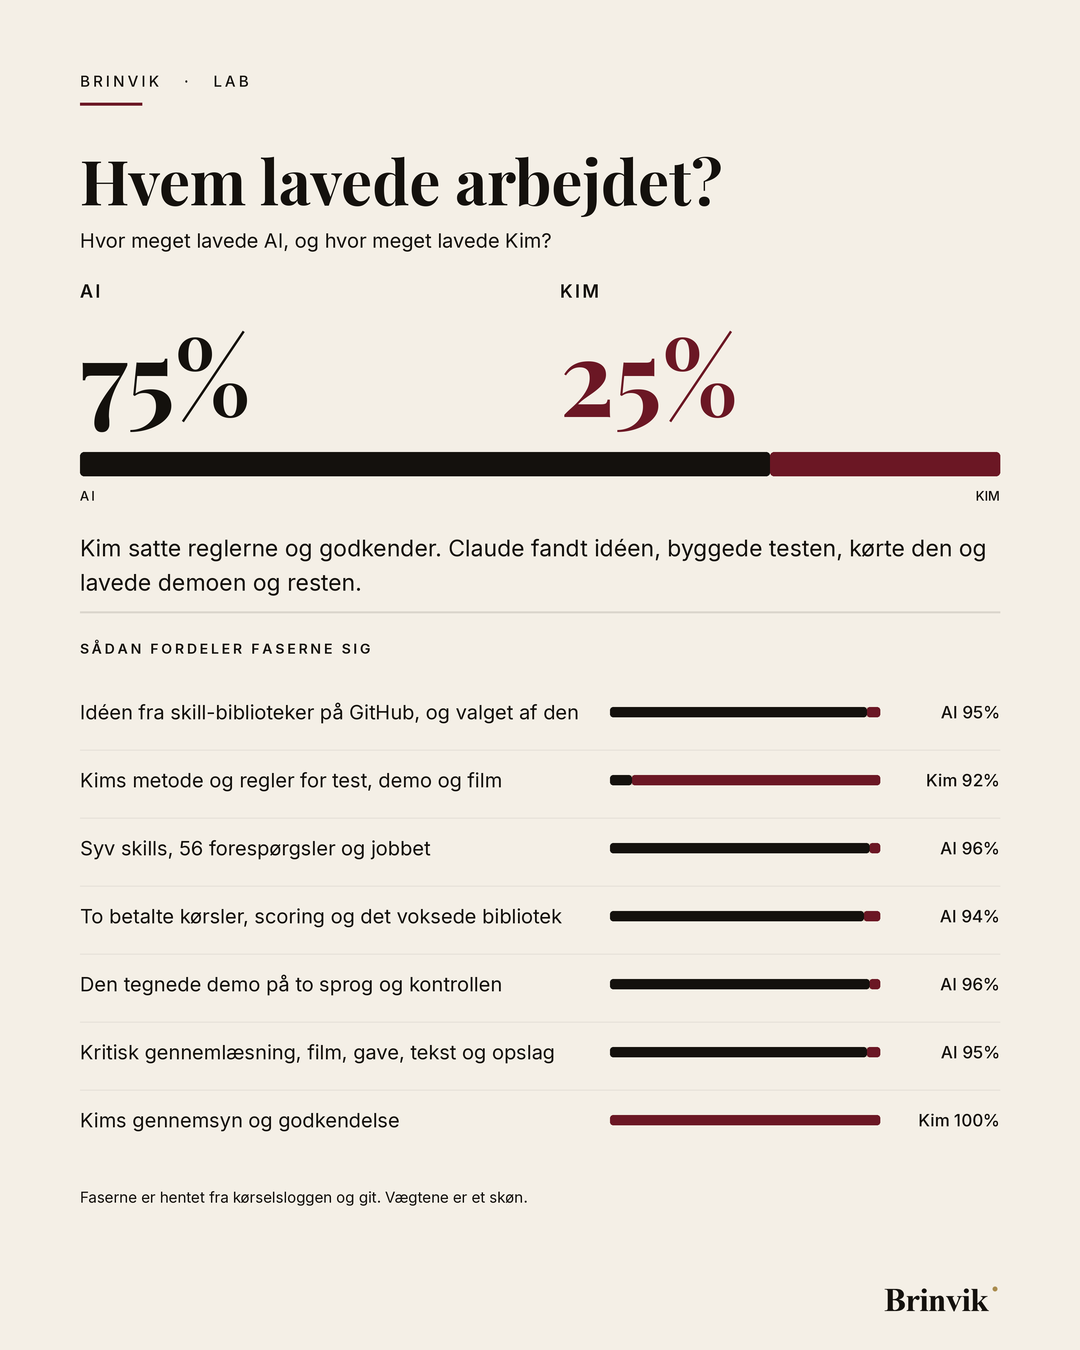
Hvem lavede arbejdet: AI 75 %, Kim 25 %. Kim fastlagde metoden og reglerne for, hvordan en test bliver til en ressource, og godkender det hele, før det går ud. Claude Code fandt idéen blandt skill-biblioteker på GitHub, skrev skillsene og forespørgslerne, kørte testen gennem Claude API, byggede demoen på begge sprog og lavede filmen og teksten. Faserne er hentet fra kørselsloggen og git; vægtene er et skøn.