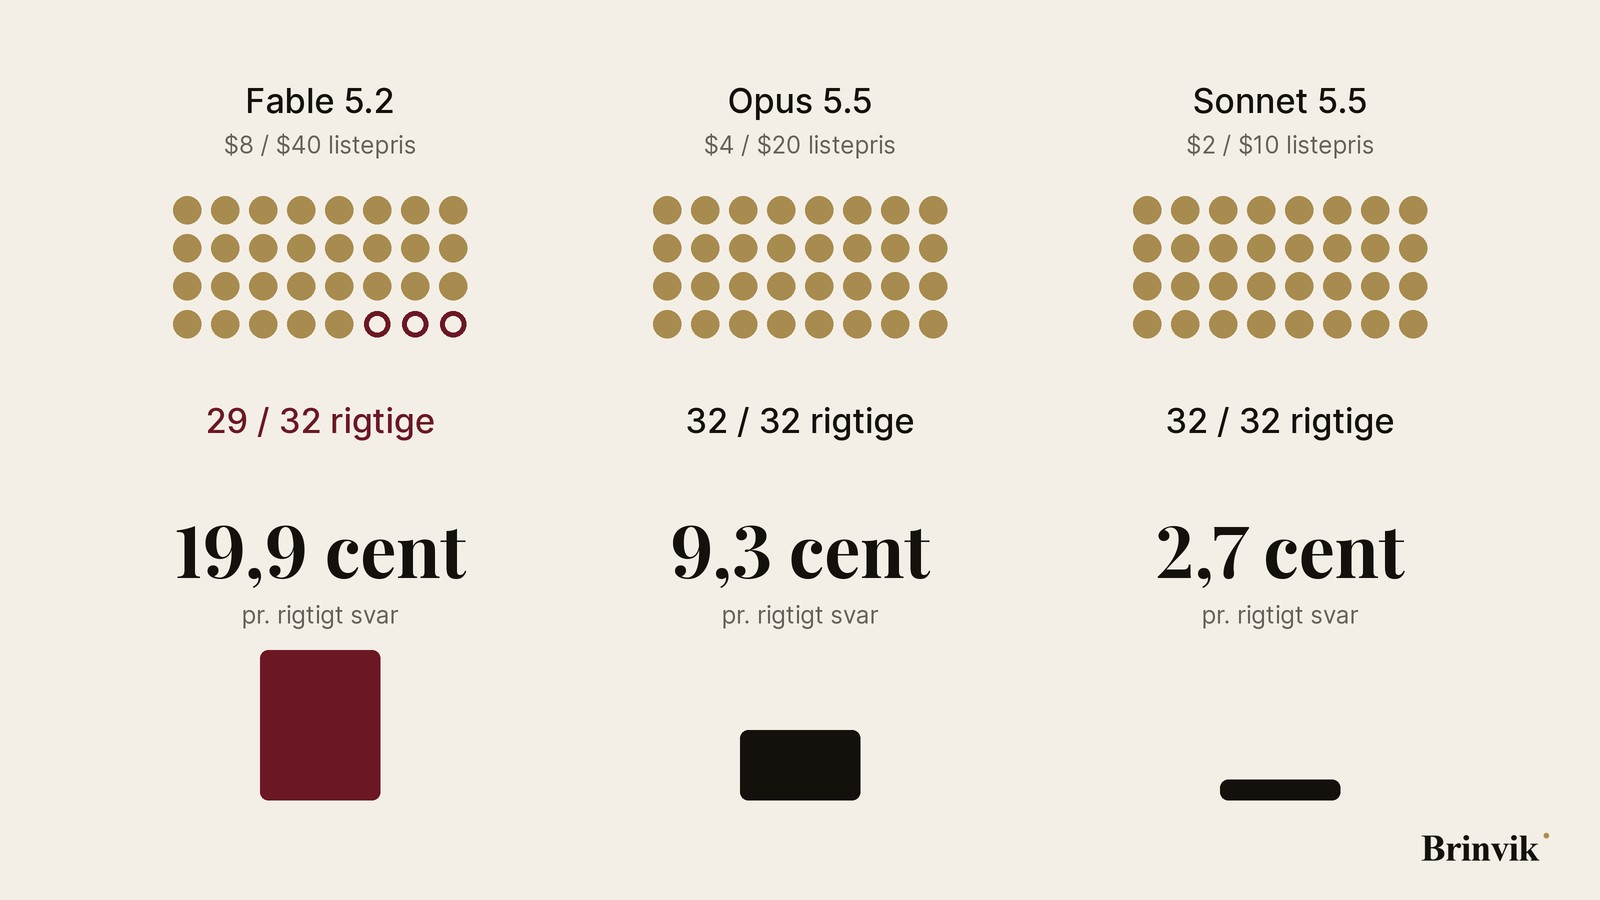
Kort fortalt: Anthropic lancerede den 9. november Claude Fable 5.2, til det dobbelte af Opus 5.5's listepris. Jeg ville vide, om den dyre model også er den, der skal svare på dine pipeline-spørgsmål. Så jeg gav Fable 5.2, Opus 5.5 og Sonnet 5.5 det samme opdigtede CRM og de otte spørgsmål, en salgsdirektør stiller om mandagen. Det blev til 96 kørsler i alt. Ingen af dem faldt i én eneste af de fælder, der får et dashboard til at tælle forkert. Sonnet 5.5 svarede rigtigt 32 ud af 32 gange og var mere end syv gange billigere pr. rigtigt svar end Fable 5.2.
Til gengæld var Fable den eneste, der hver gang sagde, at ét af spørgsmålene kunne læses på to måder. Længere nede kan du selv prøve demoen: vælg et spørgsmål og se de tre modeller slå op i databasen og lande på et tal.
Anledningen er Claude Fable 5.2, som Anthropic lancerede den 9. november. Prisen er 8 dollars pr. million tokens ind og 40 ud, ned fra 10 og 50 for Fable 5.1, og dermed det dobbelte af Opus 5.5. Anthropics egne tal viser, at Fable 5.2 matcher Opus 5.5 på svære kodeopgaver til omkring det halve pr. opgave, og et citat fra Oracle på lanceringssiden siger, at Fable 5.2 skrev SQL med rigtige totaler, hvor to unavngivne modellers SQL gav totaler, der var fem til otte gange for høje. Anthropic anbefaler selv at starte med Opus 5.5 og gå op eller ned efter behov. Det er det valg, testen her handler om, når opgaven er dine egne salgstal.

Fælderne i en helt almindelig CRM-eksport
Det opdigtede softwarefirma Saltholm Data har 150 aftaler i sit CRM, plus 12 arkiverede kopier fra dubletter, der er lagt sammen. Aftalerne ligger i fire valutaer, 9 af dem har to CFO'er registreret, fordi den gamle aldrig blev fjernet, og 16 har været i proposal mere end én gang. Intet af det er fejl. Den slags hober sig let op i et CRM, der har været i brug et stykke tid.
Det farlige er, at hver af dem giver et tal, der ser fornuftigt ud. Lægger du aftalerne sammen uden at omregne valuta, bliver den åbne pipeline 14 procent for stor. Tæller du dubletterne med, er den 7 procent for stor. Og spørger du efter aftaler, hvor CFO'en er med, og lægger sammen efter et join på kontakterne, tæller de aftaler med to CFO'er to gange, og summen bliver 25 procent for stor. Det er den slags fejl, Oracle-citatet handler om, og den slags, der kan stå i et forecast uden at blive tjekket.
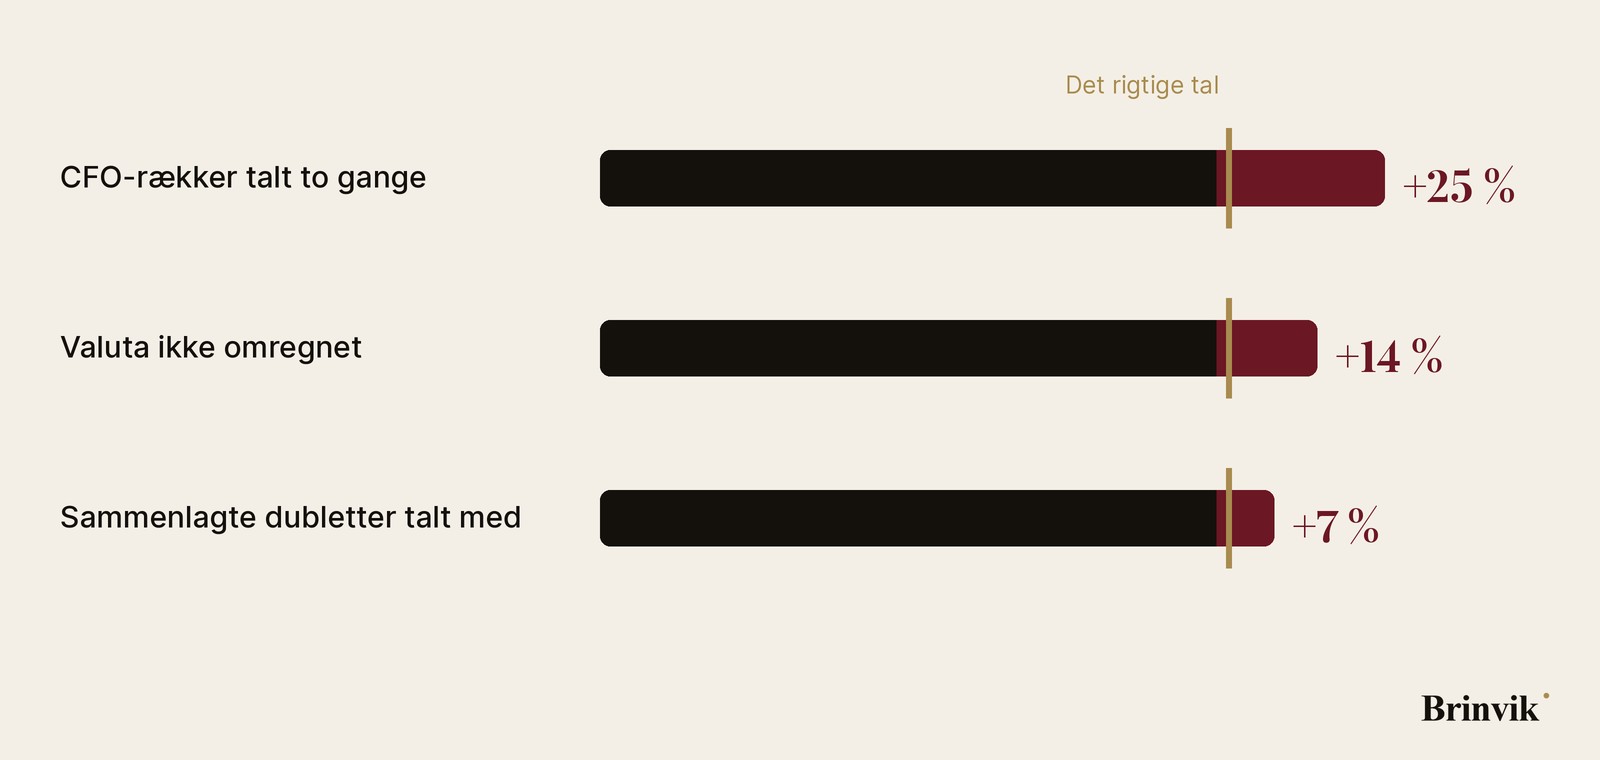

Alle tre modeller ramte det rigtige tal
Hver model fik databasens skema, et værktøj til at køre SQL og spørgsmålet fra salgsdirektøren. Den måtte slå op, så tit den ville, og skulle til sidst aflevere ét tal. Alle tre sorterede de arkiverede dubletter fra i hver eneste af de 96 kørsler og omregnede valuta i hver kørsel, der spurgte efter kroner. På CFO-spørgsmålet talte alle tre hver aftale én gang.
Så tog jeg dokumentationen væk. Halvdelen af gangene fik modellen kun kolonnenavnene, sådan som en rå eksport kommer ud, uden en linje om, hvad arkiv betyder, eller at beløb står i aftalens egen valuta. Opus og Sonnet svarede det samme med og uden dokumentationen, og Fable fik ét rigtigt svar mere uden den. Dokumentationen gjorde altså ingen forskel, man kunne måle her. Antallet af opslag steg en smule. Modellerne fandt fælderne ved at se på data i stedet for at læse om dem, og ingen af dem lagde en eneste forkert total sammen.

Den dyreste model læste ét spørgsmål anderledes
Fable 5.2 ramte ved siden af min facitliste 3 gange, og alle tre gange på det samme spørgsmål: hvad er værdien af de aftaler, der gik i proposal i oktober? Opus og Sonnet talte alle aftaler, der kom ind i proposal i oktober, og fik 3.563.279 kr. Fable talte kun de aftaler, der kom i proposal for første gang i oktober, og fik 2.797.423 kr., 21 procent mindre.
Regnestykket var i orden. Spørgsmålet kunne læses på to måder, og Fable valgte den anden og skrev det selv i sin note hver gang: "Tælles de med, bliver tallet 3.563.279 kr. fordelt på 22 aftaler." Den gav altså begge tal og afleverede det smalle.
Fable var også den eneste model, der hver gang gjorde opmærksom på, at spørgsmålet kunne læses på to måder. Sonnet nævnte det aldrig, og Opus nævnte det én gang ud af fire. Sonnet fik fuldt hus, fordi dens læsning var den, jeg havde lagt til grund. Læser man kun tallet, får man svar på et andet spørgsmål end det, man stillede.

Claude-pris: hvad koster et rigtigt svar?
Prisen er det andet sted, modellerne skilte sig ud. Jeg har ganget hver kørsels tokens med listeprisen. Et rigtigt svar kostede 2,7 cent fra Sonnet 5.5, 9,3 cent fra Opus 5.5 og 19,9 cent fra Fable 5.2. Fable brugte også længst tid: i gennemsnit 21 sekunder pr. svar mod 7 for Sonnet.
Hvad koster Claude så for et salgsteam, der stiller den slags spørgsmål hver uge? Det afhænger mest af, hvilken model du sender spørgsmålet til. Claude-pris pr. million tokens er det tal, Anthropic offentliggør, men det tal, der betyder noget for dig, er prisen pr. rigtigt svar. Her var den billigste model lige så præcis som Opus og den hurtigste. Fable 5.2 er bygget til svære, lange opgaver, og Anthropics egne målinger viser, at den er stærkest dér. En SQL-forespørgsel på et CRM med 150 aftaler er ikke en af dem.

Kan du stole på tallene?
Firmaet og aftalerne er opdigtede, men bygget som en rigtig eksport, med de fælder en rigtig eksport har. Det rigtige svar på hvert spørgsmål er regnet to gange, én gang i SQL og én gang i almindelig kode, og de to skal give det samme tal til kronen. Hver model svarede fire gange på hvert spørgsmål, to gange med dokumentation og to gange uden, med samme indstilling. Et svar tæller som rigtigt, når det ligger inden for en halv procent af det rigtige tal. Hele testen kostede 9,58 dollars.
Testen kan ikke det hele. Den viser otte spørgsmål på ét datasæt, ikke alle de spørgsmål, du kunne stille. Kolonnenavnene hjalp modellerne, også uden dokumentation: et felt, der hedder archived, er svært at overse. Og spørgsmål 5 kunne læses på to måder, hvilket er en fejl i mit spørgsmål lige så meget som i Fables svar. Den fejl er netop pointen i det sidste afsnit.
Vælg et spørgsmål i demoen ovenfor, og prøv "Gik i proposal" med og uden dokumentation for at se de to læsninger side om side.

Sådan stiller du spørgsmålet til din egen pipeline
Et rigtigt svar afhang af, om spørgsmålet kun kunne læses på én måde. Når du lader en AI-agent svare på salgstal, kan du bruge de greb, testen peger på:
-
Sig, hvilket tidspunkt der tæller. "Aftaler, der kom ind i proposal i oktober, også dem, der havde været der før", ikke "aftaler, der gik i proposal i oktober".
-
Sig, hvilken valuta og hvilke aftaler. Kroner, omregnet med dagens kurs, arkiverede dubletter udeladt.
-
Bed om læsningen før tallet. "Skriv først, hvordan du har forstået spørgsmålet, og hvis det kan læses på flere måder, så giv tallet for hver." Det var præcis det, Fable gjorde i sin note. Gør det til en del af svaret i stedet for en bemærkning.
-
Start med den billige model. Test på dine egne data med Sonnet først. Det råd bygger på denne ene test, ikke på Anthropics anbefaling, som er at starte med Opus. Gå kun op, hvis svarene ikke holder.
Som AI-konsulent hjælper jeg salgs- og RevOps-teams med AI til revenue operations: jeg sætter Claude op mod dit CRM og formulerer spørgsmålene, så de kun kan læses på én måde, og jeg tester svarene mod dine egne tal, før nogen bruger dem i et forecast. Den slags tjek hører med i enhver AI-implementering. Læs mere om AI-rådgivning, eller se hvordan et fælles Claude-budget holder i et salgsteam.
FAQ
Ofte stillede spørgsmål
Anthropics nye model fra 9. november 2026, bygget til krævende ræsonnering og lange opgaver. Den koster 8 dollars pr. million tokens ind og 40 ud.
Et rigtigt svar kostede i testen 2,7 cent med Sonnet 5.5, 9,3 cent med Opus 5.5 og 19,9 cent med Fable 5.2, regnet med listepris og de tokens, hver kørsel faktisk brugte.
Start med den billigste, der svarer rigtigt på dine egne data. Sonnet 5.5 svarede rigtigt hver gang i testen. Gem de dyre modeller til opgaver, hvor de billige fejler.
Ja, i testen. Alle tre modeller fandt valuta, dubletter og dobbelte kontakter ved at se på data, også uden dokumentation.
Den læste ét spørgsmål, som om det kun gjaldt første gang en aftale kom i proposal, og ikke hver gang. Den skrev selv det rigtige tal i sin note og var den eneste model, der hver gang nævnte begge læsninger.
Send rutinespørgsmål til en billig model, mål prisen pr. rigtigt svar i stedet for pr. token, og skriv spørgsmålene, så de kun kan læses på én måde.
Kilder
- Introducing Claude Fable 5.2 and Claude Mythos 5.2, Anthropic, 9. november 2026
- Claude Platform release notes, 9. november 2026
- Pricing, Claude Platform, læst 9. november 2026