Kort fortalt: Claude Haiku 5.5 kom den 7. oktober og koster en tiendedel af Haiku 4.5 pr. token. Samme dag meddelte Anthropic, at Max og Team får en månedlig API-kredit. Jeg fik Claude Code til at lade begge Haiku-modeller sortere 300 opdigtede henvendelser fra en dansk kontaktformular. Haiku 5.5 lagde 291 i den rigtige bunke, Haiku 4.5 299. De to var uenige om 10 henvendelser, og alle fejlene lå blandt dem. Lad to modeller sortere, og læs kun dem, de er uenige om. Prompt, testhenvendelser og script er gratis: hent zip-filen.
Filmen viser én af de ti uenigheder. I demoen herunder kan du klikke dig gennem alle 300 henvendelser med syv forskellige sorteringer og se, hvor langt den månedlige kredit rækker.
Den 7. oktober lancerede Anthropic Haiku 5.5, sin nye lille model og, til listepris, den billigste. Den koster 0,10 dollar pr. million input-tokens og 0,50 dollar pr. million output-tokens, mod 1 og 5 dollar for Haiku 4.5. Anthropic anbefaler den til mange ens opgaver, der hver især er enkle og afgrænsede, og nævner klassificering som et af eksemplerne.
Samme dag meddelte Anthropic, at Max og Team får en månedlig API-kredit: 100 dollar på Max 5x og 200 dollar på Max 20x. På Team er det 20 dollar pr. Standard-plads og 100 dollar pr. Premium-plads, samlet i én pulje på højst 500 dollar. Free, Pro og Enterprise får den ikke. Kreditten gælder API'et, Batch API, Claude Managed Agents, Agent SDK og Playground, ikke interaktiv brug af Claude Code. Den udløber ved slutningen af hver faktureringsperiode, og det, du ikke bruger, går tabt.
Har du en Team-plan og en kontaktformular, er sortering af henvendelser et oplagt første job for kreditten. Derfor lod jeg Claude Code skrive 300 opdigtede henvendelser til et opdigtet dansk firma, Vagtly ApS, der sælger vagtplanlægning til rengørings- og plejevirksomheder. Seks bunker, 50 henvendelser i hver, og en svarnøgle, som Claude Opus 5.5 gennemgik uafhængigt og var enig i hele vejen igennem, før en eneste model blev målt.

Hvad koster det at lade Claude sortere henvendelser?
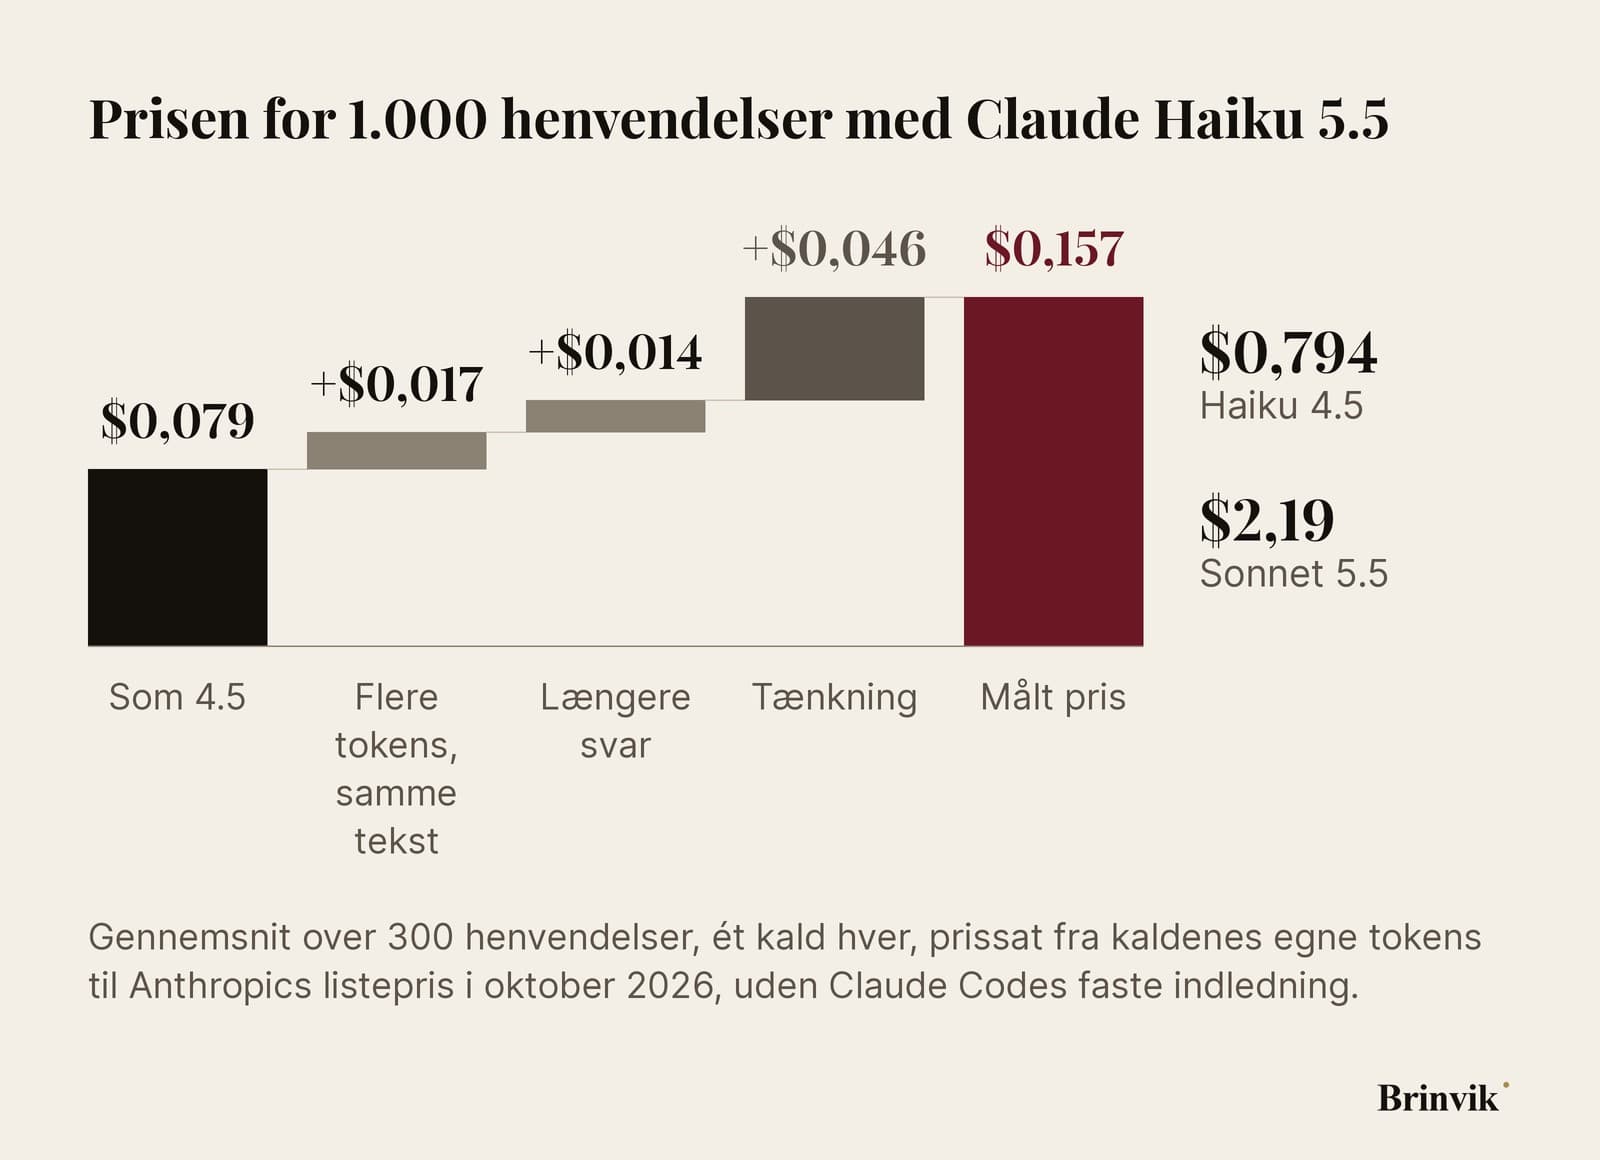
Hver henvendelse blev sendt for sig med den samme prompt, og prisen er regnet ud fra hvert kalds egne tokens (de små tekststykker, en model afregnes i) til Anthropics listepris. At sortere 1.000 henvendelser kostede 0,157 dollar med Haiku 5.5, 0,794 dollar med Haiku 4.5 og 2,19 dollar med Sonnet 5.5.
Efter listeprisen er Haiku 5.5 ti gange billigere end Haiku 4.5. Her blev det omkring 5,1 gange, af to grunde. Den nye tokenizer, som Anthropic selv skriver om i migreringsguiden, delte i testen den samme tekst op i en tredjedel flere tokens. Og Haiku 5.5 tænker som standard: af 181 output-tokens pr. henvendelse gik 93 til tænkning, mens Haiku 4.5 svarede med 59.
Indsatsniveauet, der styrer, hvor meget modellen tænker, før den svarer, er det oplagte sted at spare, og Anthropic foreslår selv lav indsats til enkle opgaver i store mængder. På lav indsats sparede Haiku 5.5 10 procent og lagde 285 i den rigtige bunke mod 291. På høj indsats lagde den 293 rigtigt.
Prisen er ikke det, du skal vælge efter. En enkelt Standard-plads på Team giver 20 dollar om måneden, og det dækker omkring 127.000 henvendelser med Haiku 5.5. Selv 5.000 henvendelser om måneden koster under 1 dollar. Langt vigtigere er det at vide, hvilke af dem modellen har lagt forkert.

Haiku 5.5 og Haiku 4.5 var uenige om 10 af 300 henvendelser
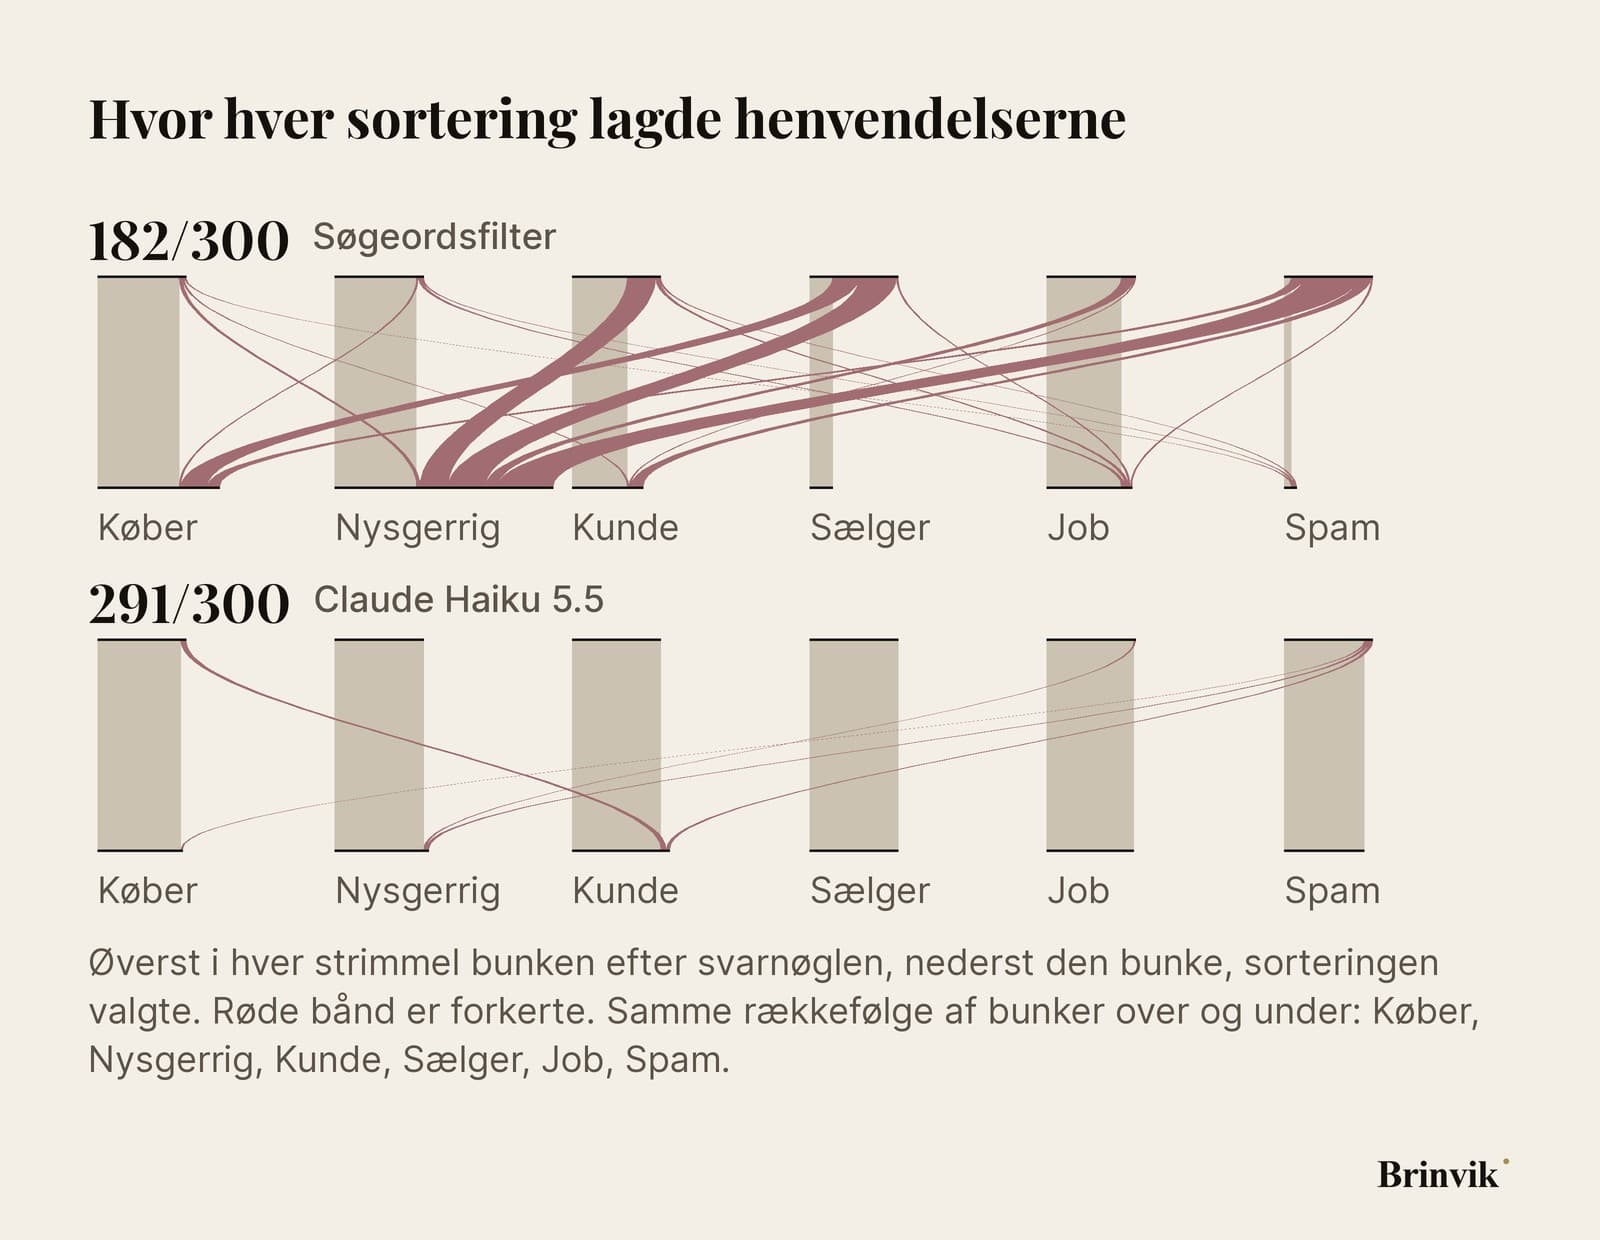
Haiku 5.5 lagde 291 af 300 i den rigtige bunke. Haiku 4.5, den forrige Haiku-model, lagde 299. Sonnet 5.5 sorterede alle 300 rigtigt. Den nyeste og billigste model var altså ikke den mest præcise på dette job.
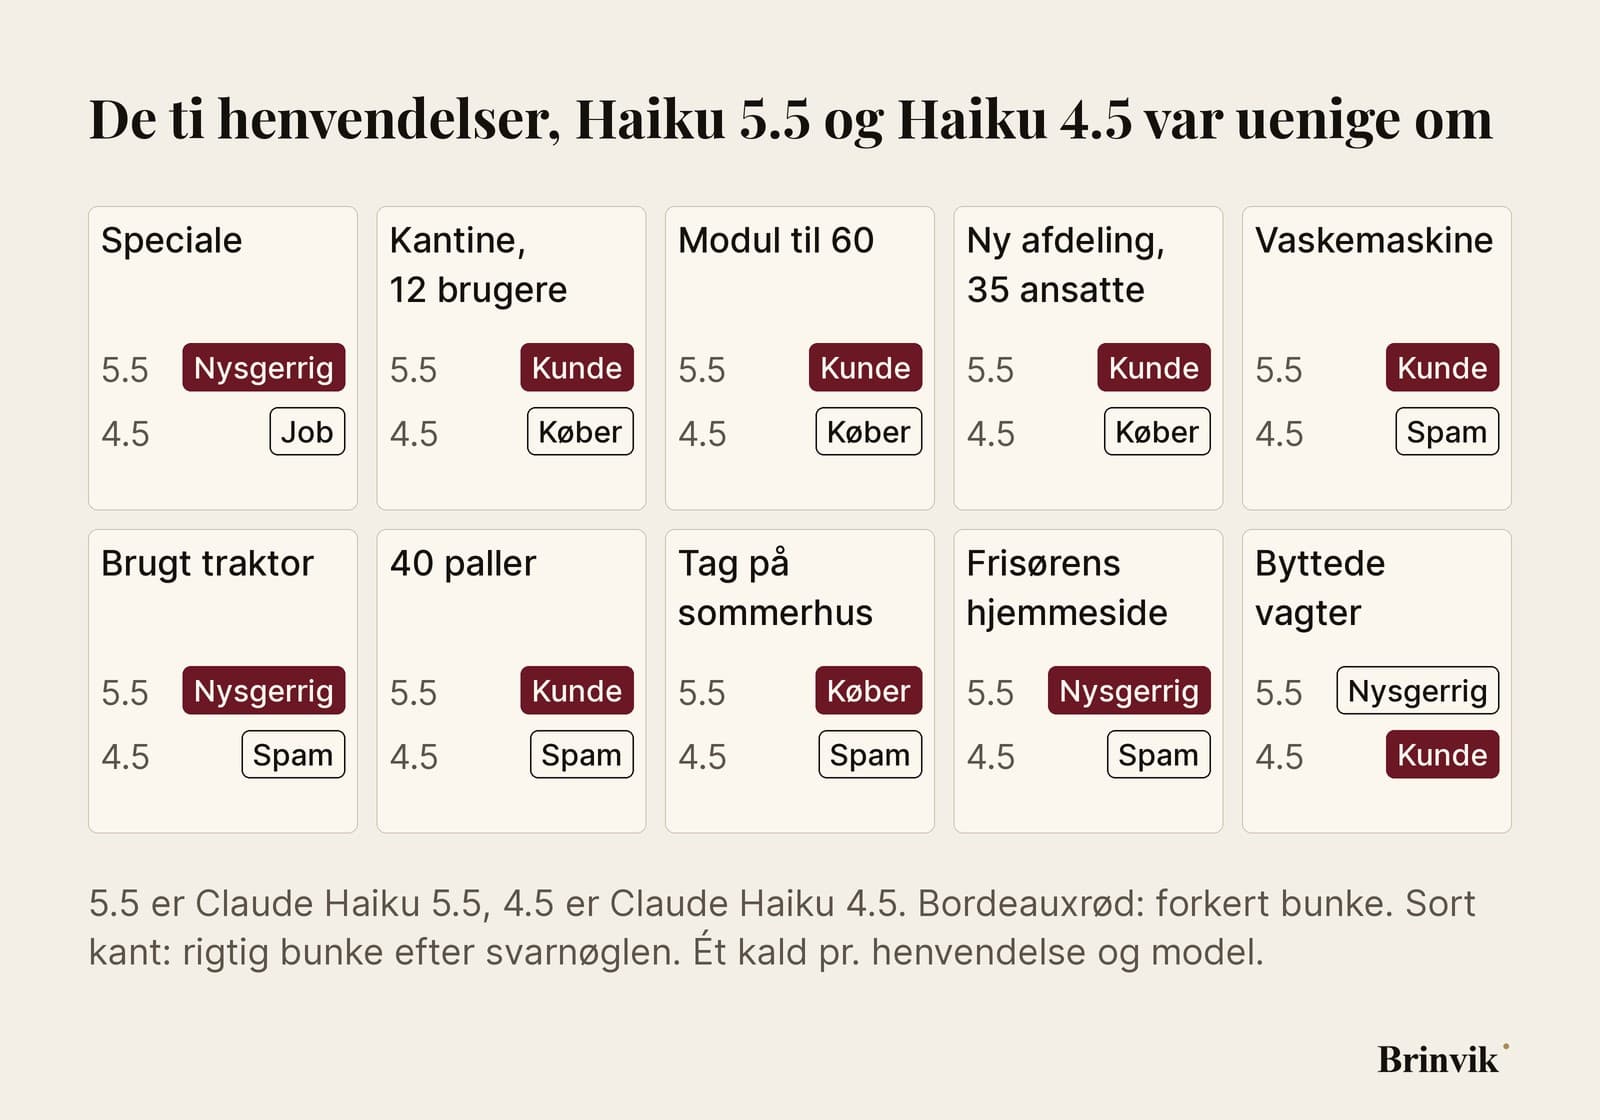
De to Haiku-modeller var uenige om 10 henvendelser, og alle 9 fejl fra Haiku 5.5 og den ene fra Haiku 4.5 var blandt de 10. Der var ingen henvendelse, hvor begge tog fejl. Hvis du kun læser de henvendelser, de to er uenige om, læser du 10 af 300 og finder alle fejlene.
De ni fejl fra Haiku 5.5 var af tre slags. Fem henvendelser var tydeligvis skrevet til et helt andet firma: én ville have repareret en vaskemaskine, én ledte efter en brugt traktor, én bekræftede en levering af 40 paller, én ville have en ny hjemmeside til en frisørsalon, og én ville have et nyt tag på et sommerhus. Haiku 5.5 lagde dem i Kunde, Nysgerrig og Køber. Til sommerhuset foreslog den at aftale en besigtigelse af taget.
Tre var eksisterende kunder, der ville købe mere: et modul til 60 medarbejdere, en ny afdeling i Aarhus med 35, en kantine med 12 brugere. Haiku 5.5 lagde dem alle tre i Kunde, altså i supportkøen, selv om prompten siger, at en kunde, der vil udvide, er en køber. Den sidste, en studerende, der ville skrive speciale, endte i Nysgerrig i stedet for Job.
Haiku 4.5's ene fejl var en henvendelse om, hvordan man ser, hvem der har byttet vagter. Modellen lagde den i Kunde i stedet for Nysgerrig.
Enighed er ikke et bevis. To modeller kan begå samme fejl, og så slipper den igennem uden at blive set. I denne test skete det ikke én gang, men det er grunden til, at metoden finder fejl og ikke garanterer for resten.
For at se, om mønsteret holdt, skrev Claude Code 60 nye henvendelser bagefter: 20 kunder, der ville købe mere, 20 henvendelser til andre firmaer og 20 helt almindelige supportsager. Haiku 5.5 sorterede 57 rigtigt, Haiku 4.5 59. De var uenige om 4, og alle 4 fejl lå igen blandt dem. Haiku 5.5 sorterede alle 20 kunder, der ville købe mere, rigtigt denne gang. Fejlen med andre firmaers henvendelser gik derimod igen: to om en sofa og én om et par vandrestøvler endte i Kunde.
Et søgeordsfilter klarede 182 af 300. Det sendte 15 sælgere og 7 spambeskeder i Køber, heraf fem til andre firmaer, fordi de skrev ord som tilbud og pris.
Når du har set, hvilken slags fejl modellen laver, kan du skrive den ind i prompten. Claude Code tilføjede to linjer lige efter beskrivelsen af bunkerne, som et tjek i rækkefølge: Handler henvendelsen overhovedet om firmaet, og vil en kunde købe mere? Med dem lagde Haiku 5.5 298 af 300 rigtigt og alle 60 nye henvendelser. Linjerne blev skrevet, efter at Claude Code havde læst fejlene, og derfor blev de prøvet på de 60 nye henvendelser, før de kom i zip-filen. De koster omkring 23 procent mere pr. henvendelse, fordi prompten bliver længere og modellen tænker mere.

Sådan kører du testen på din egen indbakke
Zip-filen har prompten med og uden de to linjer, de 300 testhenvendelser, svarnøglen og et lille Python-script, sort_inbox.py, der sender henvendelserne til Claude, viser bunkerne og til sidst tæller fejl, tokens og pris. Det kører på API'et med en nøgle fra den Console-organisation, kreditten er koblet til. Kører du det samme job gennem Claude Code, logget ind med dit abonnement, trækker det på abonnementets grænser og ikke på kreditten.
- Skriv første afsnit af prompten om til din egen forretning, og bunkerne om til dem, dit team arbejder med.
- Eksportér 200 rigtige henvendelser fra formularen eller indbakken.
- Kør dem gennem to modeller, for eksempel Haiku 5.5 og Haiku 4.5.
- Læs kun dem, de to er uenige om, og afgør, hvem der har ret. Det er din svarnøgle til den slags fejl, der koster noget.
- Skriv den fejl, du ser oftest, ind som et tjek lige efter bunkerne i prompten, og kør igen.
- Giv jobbet sit eget workspace med en grænse for forbrug, og send den månedlige kørsel gennem Batch API, der koster halvdelen.
Testen viser ikke alt. Henvendelserne er opdigtede, korte og tydelige, og en rigtig indbakke er mere rodet. Hver henvendelse blev kørt én gang pr. model, så en forskel på en til tre fejl kan være tilfældig. Kaldene gik gennem Claude Code og er prissat som API-kald, ikke faktureret. Og testen siger intet om hastighed, fordi maskinen var hårdt belastet undervejs.

AI-agenter, der sorterer dine henvendelser
Som AI-konsulent sætter jeg AI-agenter op, der tager imod henvendelser fra hjemmesiden, sorterer dem og opretter dem i HubSpot. Det svære er sjældent modellen. Det er at blive enig om bunkerne, at koble to modeller på formularen og CRM'et og at bestemme, hvem der læser de henvendelser, modellerne er uenige om, og hvor hurtigt.
Det er den slags AI-automatisering, der ligger i en AI-agent til hjemmesiden. Send mig dine seks bunker og tre rigtige henvendelser med navnene fjernet, så kan jeg se, hvad prompten skal kunne. Vil du se, hvordan modelvalget afhænger af opgaven, så læs testen af Sonnet 5.5 mod Opus 5.5.
FAQ
Ofte stillede spørgsmål
Haiku 5.5 koster 0,10 dollar pr. million input-tokens og 0,50 dollar pr. million output-tokens, når prompten er under 100.000 tokens. Over det koster den 0,50 og 2,50 dollar. Gennem Batch API er prisen det halve.
I testen her kostede 1.000 henvendelser omkring 0,16 dollar med Haiku 5.5, 0,79 dollar med Haiku 4.5 og 2,19 dollar med Sonnet 5.5 til listepris. Tænkning og den nye tokenizer gør Haiku 5.5 dyrere pr. henvendelse, end listeprisen alene antyder.
Nej. Kreditten på Max og Team gælder API'et, Batch API, Claude Managed Agents, Agent SDK og Playground. Interaktiv brug af Claude Code og ekstra forbrug i Claude-apps er ikke dækket, og claude -p tæller kun med en API-nøgle fra den organisation, kreditten er koblet til.
Ved slutningen af hver faktureringsperiode. Ubrugt kredit overføres ikke. På Team giver hver Standard-plads 20 dollar og hver Premium-plads 100 dollar, samlet i én pulje på højst 500 dollar om måneden.
I testen sorterede Sonnet 5.5 alle 300 rigtigt, Haiku 4.5 299 og Haiku 5.5 291. Prisen er så lav for alle tre, at den sjældent afgør det. Kør to modeller, og læs dem, de er uenige om: I testen lå alle fejlene dér.
På de 300 danske testhenvendelser sorterede Haiku 5.5 291 rigtigt. Fejlene skyldtes ikke sproget. Otte af de ni var henvendelser skrevet til et andet firma eller fra kunder, der ville købe mere.
Har organisationen andre kreditter, fortsætter forbruget på dem. Ellers stopper API-kaldene, til næste måneds kredit kommer, og intet bliver trukket på dit Claude-abonnement.
Kilder
- Anthropic: »Introducing Claude Haiku 5.5« (7. oktober 2026)
- Claude Platform Docs: »API credits for Max and Team plans«
- Claude Help Center: »Monthly API credits for Max and Team plans«
- Claude Platform Docs: »Pricing«
- Claude Platform Docs: »Effort«
- Claude Platform Docs: »Claude Haiku 5.5 migration guide«
- Brinvik: lead-sorter-kit, vejledning til prompt, testhenvendelser og script