TL;DR: Jeg testede, hvor god Claude Sonnet 5.5 er, på et realistisk stykke salgsarbejde. Den fik en rodet CRM-eksport med 61 deals og ni slags fejl, jeg havde plantet med vilje, og skulle levere en Q4-prognose i Excel og fem slides til bestyrelsen. Derefter fik Opus 5.5 præcis samme opgave. Begge ramte prognosen på kronen, 6.529.724 kr., og begge fandt alle ni fejltyper. Med mit eget stopur var Sonnet færdig på 2 minutter og 3 sekunder, Opus på 3 minutter og 16 sekunder, og omregnet til API-listepris kostede det 0,58 dollar mod 1,39. Opus byggede det bedste deck. Min konklusion: Sonnet til analysen, du kører hver uge. Opus til det, bestyrelsen ser.
Claude Sonnet 5.5 kom den 28. september. Jeg har skrevet om, hvad skiftet til Sonnet 5.5 betyder for dine agenter. Men det, jeg selv ville vide, var noget andet: Hvor god er den til det arbejde, et salgsteam faktisk laver?
Så klokken to om natten gav jeg den et job som RevOps-analytiker. Bagefter gav jeg præcis samme job til Opus 5.5, Anthropics dyrere model til det svære arbejde. Samme prompt og samme fil, sendt i to vinduer i Claude-appen på samme tid. Filmen ovenfor viser de to kørsler side om side, genskabt fra kørslernes logs og de rigtige filer og spolet frem. Uret går i virkelig tid.

Opgaven: en rodet CRM-eksport og et bestyrelsesmøde
Virksomheden hedder Havblik Software ApS. Den findes ikke. Det gør pipelinen heller ikke, men den ligner en, jeg har set mange gange: 61 deals eksporteret fra et CRM en tirsdag morgen, fordi økonomichefen skal bruge et tal til bestyrelsen.
Modellen skulle gøre tre ting. Rense dataene uden at slette noget i det stille. Bygge en vægtet omsætningsprognose for Q4 2026 i danske kroner med faste sandsynligheder per fase, fra 10 procent for Qualified til 70 procent for Negotiation, og euro omregnet til 7,46. Og levere tre filer: et Excel-ark med levende formler, fem slides, som en økonomichef kan præsentere uden at rette i dem, og en liste over hver eneste datafejl.
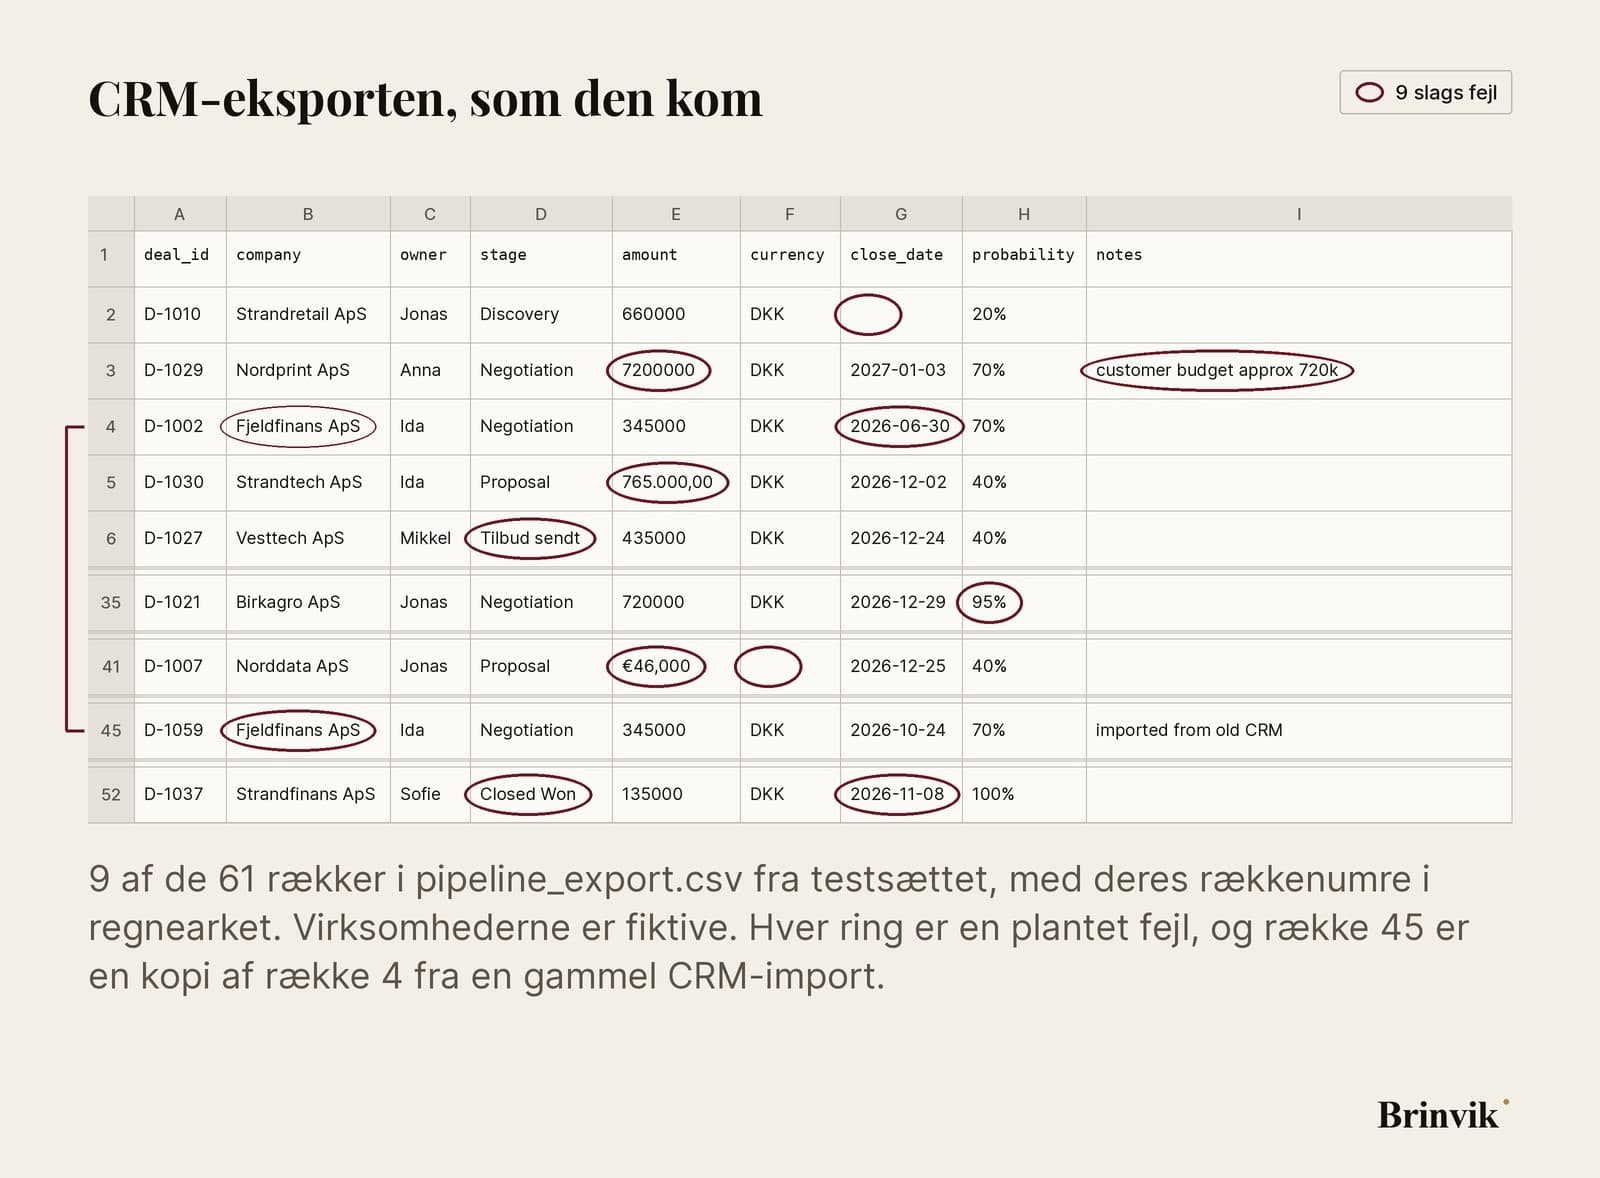
Der var ni slags fejl. Tre deals lå der to gange efter en gammel import. Fire beløb var i euro, og på to af dem stod valutaen kun som et €-tegn. Faserne optrådte med fem afvigende stavemåder, to af dem på dansk. Fem åbne deals havde en lukkedato, der allerede var passeret, og fire havde ingen. Tre sandsynligheder passede ikke til fasen. Fire beløb stod med dansk talformat som tekst. Én deal havde et nul for meget. Og én var markeret som vundet med en lukkedato i november.
Før nogen af modellerne så filen, skrev jeg facitlisten: 6.529.724 kr. fra 27 deals, og hver fejl med deal-ID. Så kunne ingen af dem overbevise mig med et flot slide.

Samme prognose, på kronen
Begge modeller landede på 6.529.724 kr. fra 27 deals. Præcis facit. Begge fandt alle ni fejltyper, beholdt alle 61 rækker og byggede Excel-arket med rigtige formler, der regner om, hvis du retter en sandsynlighed. Ingen af dem skrev totalen ind som et tal.
De traf også de samme svære valg. Dealen med 7,2 mio. kr. og en note om et budget på cirka 720.000 blev rettet til 720.000 og markeret, så sælgeren kan bekræfte det. Dubletterne blev holdt ude, originalerne beholdt. Deals uden lukkedato kom ikke med i Q4, fordi de ikke kan placeres i et kvartal.
Forskellen lå i det, de hver især fik øje på bagefter. Opus så, at to af dubletterne havde lukkedatoer i Q4, mens originalerne havde passerede datoer, og regnede ud, at prognosen stiger med 0,30 mio. kr., hvis salg bekræfter de nye datoer. Sonnet satte de samme 0,30 mio. kr. på sit slide om muligheder og stillede også spørgsmålstegn ved en deal på 75.000, der måske skulle have været 750.000. Beløbet på 75.000 var faktisk rigtigt. Men det er den slags tvivl, jeg hellere vil have på skrift end slet ikke høre om.

Sonnet 5.5 var hurtigere og halvt så dyr per token
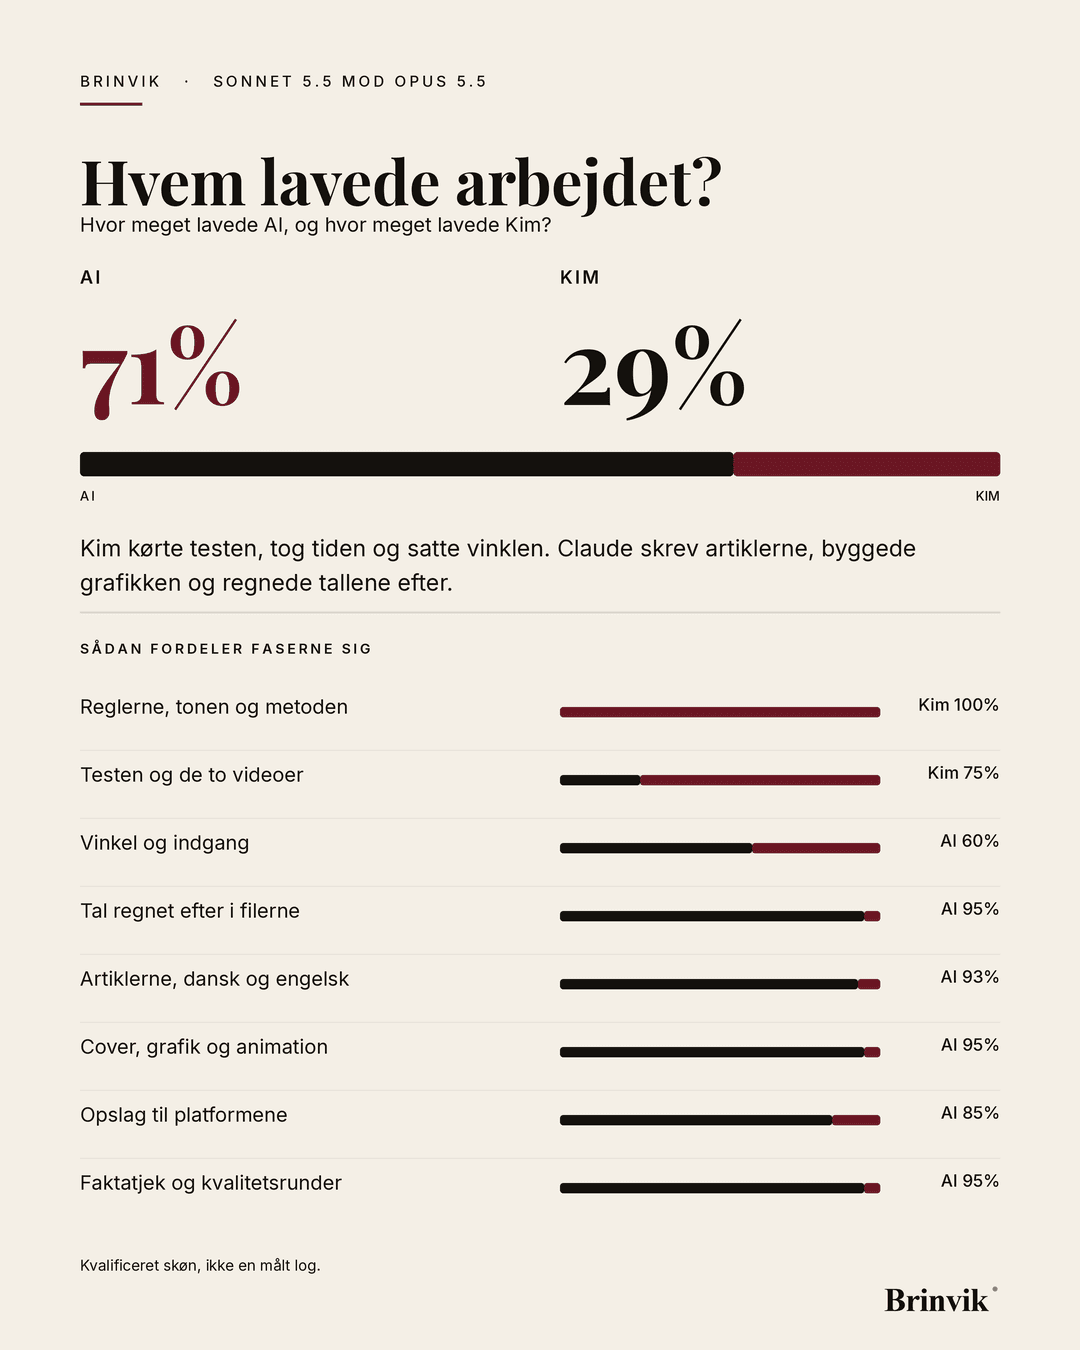
Sonnet 5.5 var færdig på 2 minutter og 3 sekunder med 9 værktøjskald. Opus 5.5 brugte 3 minutter og 16 sekunder og 15 kald. Det er min egen måling fra én kørsel hver, og tiden svinger fra kørsel til kørsel.
Prisen svinger ikke. Sonnet 5.5 koster 2 dollar per million input-tokens og 10 dollar per million output-tokens. Opus 5.5 koster 4 og 20. Det halve per token, for samme tal.
Omregnet til Anthropics listepriser ud fra token-tallene i hver kørsels log kostede kørslen 0,58 dollar for Sonnet og 1,39 dollar for Opus. Sonnets output-tokens er et skøn. Opus kostede altså knap to en halv gang så meget, fordi den både er dyrere per token og brugte flere af dem.
Hvad Opus brugte de seks ekstra kald på, har jeg ikke gravet i, men det meste af forskellen kan ses i det, den leverede.

Opus 5.5 byggede det deck, jeg ville vise en bestyrelse
Opus lavede fem slides, der hænger sammen. Tre nøgletal øverst. Et søjlediagram med en tabel over faser ved siden af. Et slide, der viser, at december står for halvdelen af kvartalet, 3,37 mio. kr. ud af 6,53, ved siden af kvartalet fordelt per sælger. Et slide om oprydningen med tre kort, der fortæller, hvad den betød for tallet. Og til sidst risici, muligheder og hvad salg skal rette inden den 6. oktober.
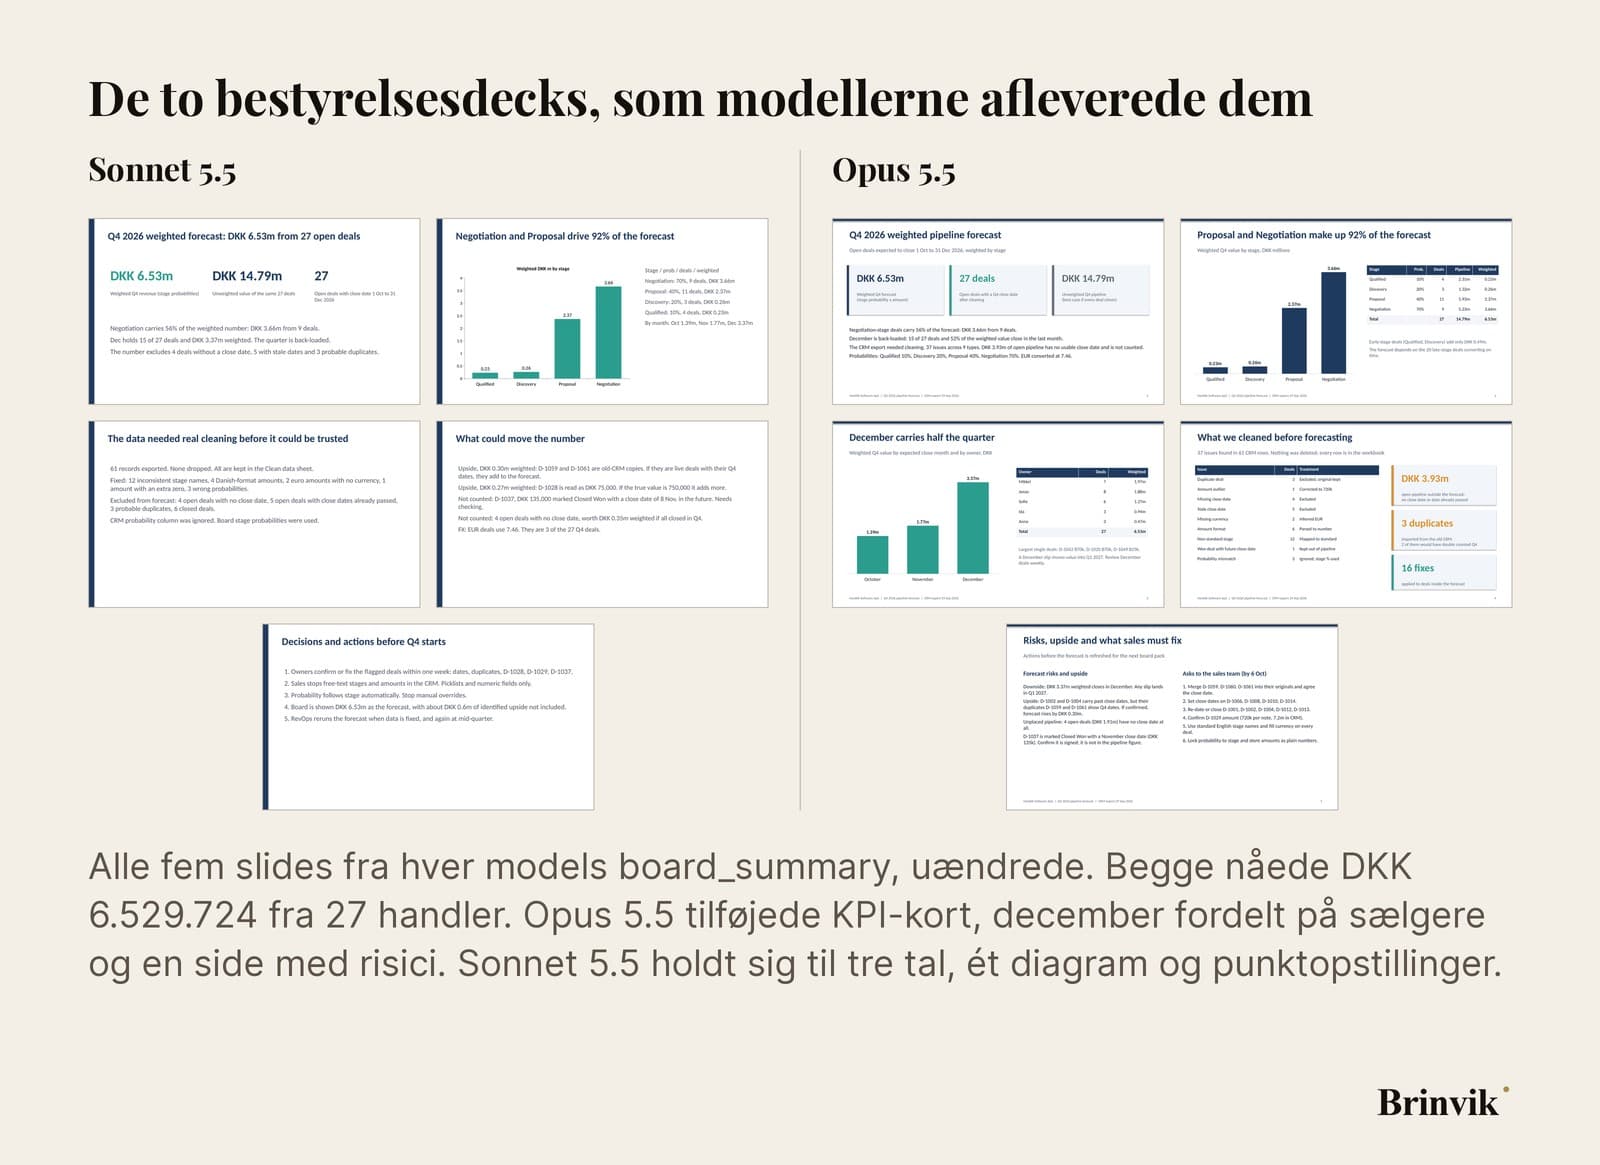
Sonnets deck var korrekt. Tallene stod der, konklusionerne var rigtige, og slide 4 om, hvad der kan flytte tallet, var faktisk skarpt. Men efter de to første slides var det tekst i punktform. En økonomichef kunne bruge det, men ingen ville glæde sig til at præsentere det.
Det passer med det, Anthropic selv skriver ved lanceringen: Sonnet 5.5 er stærkest til afgrænsede hverdagsopgaver, mens Opus 5.5 stadig er klart stærkere til komplekst, åbent arbejde, der kræver dømmekraft over tid. Et bestyrelsesdeck kræver dømmekraft: Hvad skal med, hvad skal fremhæves, og hvad skal bestyrelsen være bekymret for?

Sådan ville jeg fordele arbejdet, når du bruger AI til salg
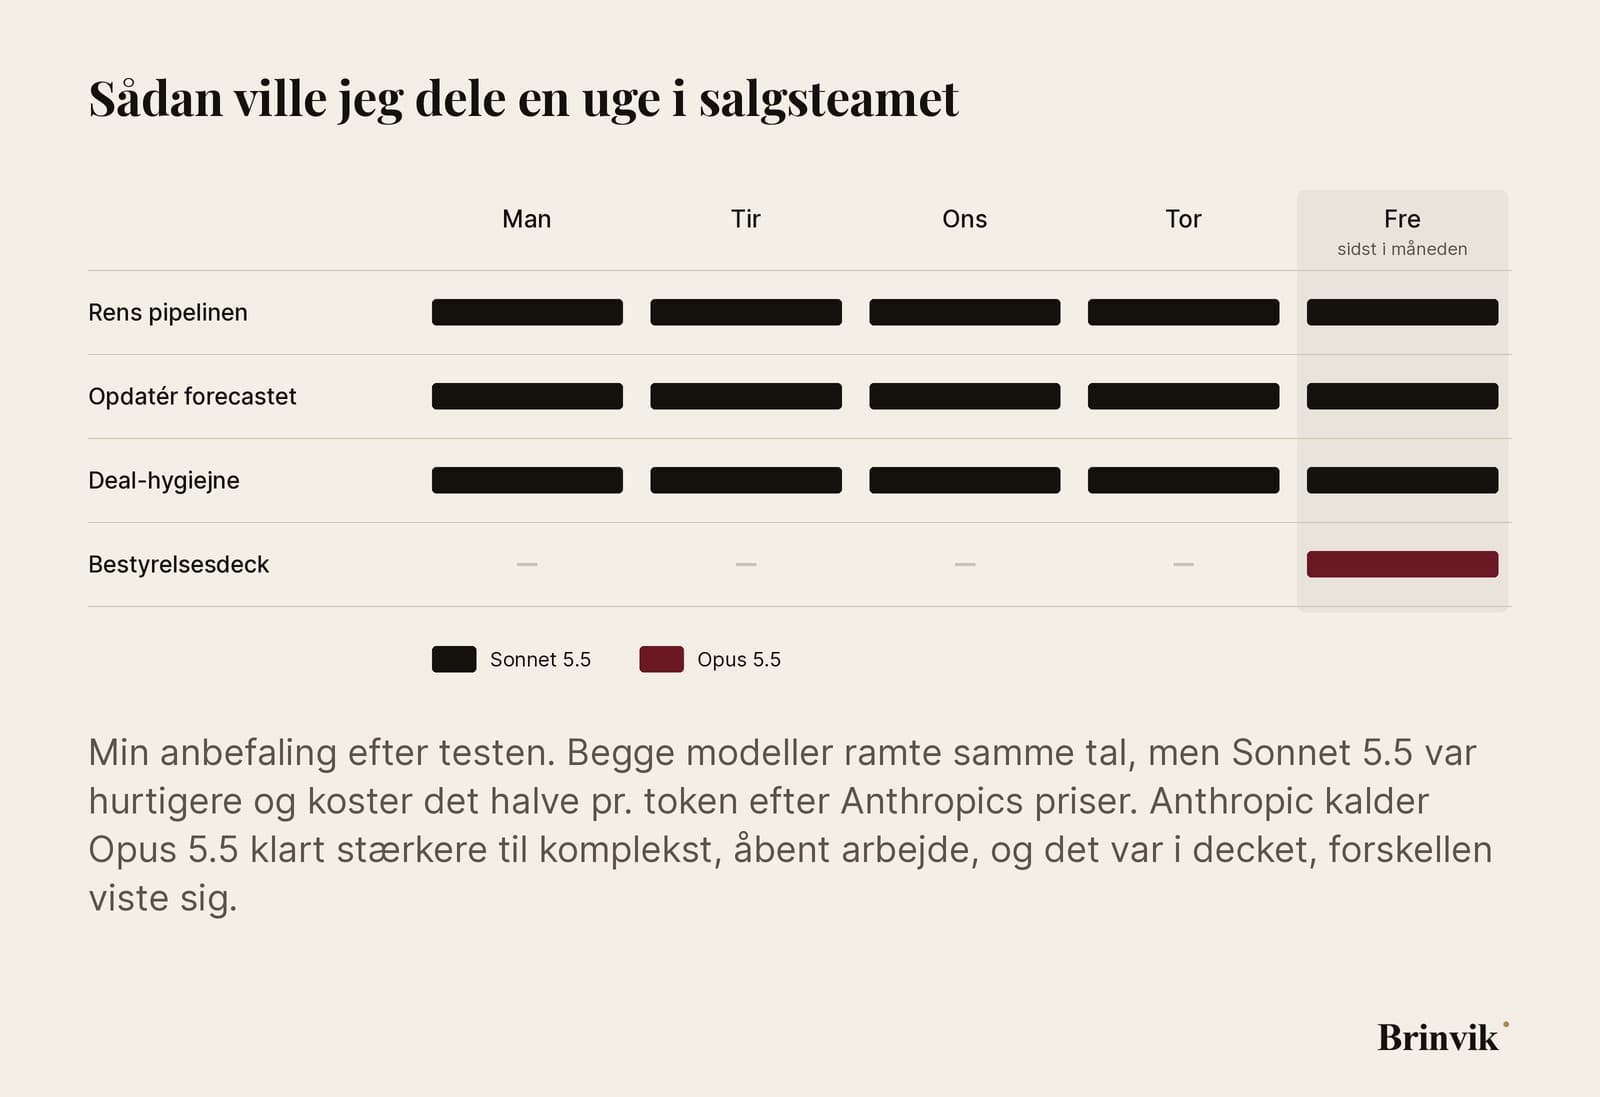
Vælg modellen efter leverancen, ikke efter virksomheden. Det er min holdning efter testen, og den er ikke den, jeg havde, da jeg startede. Jeg regnede med at finde en vinder.
I stedet fandt jeg to forskellige jobs. Den ugentlige analyse, hvor du skal have tallet rigtigt og fejlene fundet, gjorde Sonnet lige så godt som Opus, hurtigere og til den halve pris per token. Det, der skal foran en bestyrelse, gjorde Opus bedre, og dér betyder et minut og den dobbelte tokenpris ingenting.
Sådan ser AI til salg ud i praksis: Den kedelige del bliver AI-automatisering, der kører hver uge på den billige model, og den dyre bruger du dér, hvor dømmekraften tæller.
Én ting ændrer sig ikke, uanset hvilken model du vælger. Begge modeller markerede deals, som et menneske skal svare på: beløbet med et nul for meget, den vundne deal med en dato i fremtiden, de tre dubletter. En model kan finde fejlen. Den kan ikke ringe til sælgeren og spørge.

Hvad testen ikke viser, og sådan kører du den selv
Én kørsel per model, på data, jeg selv har opfundet, med en facitliste, jeg selv har skrevet. Det er et første kig, ikke en benchmark. Tiden er målt af mig, og en anden kørsel kan give et andet tal. Intet gik i stykker undervejs, men Sonnets tvivl om dealen på 75.000 var en falsk alarm, og i en rigtig pipeline koster en falsk alarm en sælgers tid.
Derfor kan du hente hele testen og køre den selv. Hent testpakken her. Den indeholder prompten, som begge modeller fik, CSV-filen med de 61 deals, facitlisten og begge modellers filer, som de blev leveret. Sæt din egen eksport ind i stedet, anonymiseret, og skriv din egen facitliste, før du ser på svaret.
I min artikel om Opus 5.5 skrev jeg, at den eneste måling, der er noget værd, er den, du laver på dit eget arbejde. Det her er min måling, kørt én gang. Den siger først noget om dine data, når du har kørt den på dem.

Interne AI-værktøjer til salgsteams: det bygger jeg
Som AI-konsulent bygger jeg AI-agenter til danske salgsteams: en agent, der renser pipelinen og opdaterer prognosen hver uge, og som skriver en liste til sælgerne over det, kun de kan svare på. Det svære er sjældent modellen, men at få facitlisten skrevet, så du kan se, om agenten har ret, før du lader den køre alene. Det hører under interne AI-værktøjer, og det er dér, Claude til virksomheder gør størst forskel i et salgsteam.
FAQ
Ofte stillede spørgsmål
Ja, i min test. Den ramte den vægtede Q4-prognose præcis, 6.529.724 kr. fra 27 deals, og fandt alle ni plantede fejltyper. Det er én kørsel på opfundne data, så kør testen på din egen eksport, før du stoler på den.
Det halve per token. Sonnet 5.5 koster 2 dollar per million input-tokens og 10 dollar per million output-tokens. Opus 5.5 koster 4 og 20. I min test svarede token-forbruget til 0,58 dollar for Sonnet og 1,39 dollar for Opus i listepris.
Når leverancen kræver dømmekraft: hvad der skal med, hvad der skal fremhæves, hvad modtageren skal være bekymret for. I testen byggede Opus det bedste bestyrelsesdeck. Anthropic skriver selv, at Opus 5.5 stadig er klart stærkere til komplekst, åbent arbejde.
Ja. Testpakken indeholder prompten, CSV-filen og facitlisten. Brug en anonymiseret eksport, skriv din egen facitliste først, og tjek din databehandleraftale, før du sender rigtige kundedata til en AI-model.
Ja, begge. Prognosearket regner med COUNTIFS og SUMIFS (TÆL.HVISER og SUM.HVISER i dansk Excel) på det rensede dataark, så tallet ændrer sig, hvis du retter en sandsynlighed eller en deal. Ingen af dem skrev totalen ind som et fast tal.
Start med én fast opgave, du allerede laver hver uge, for eksempel oprydning i pipelinen eller prognosen. Skriv en facitliste for en uge, du kender svaret på, og lad Claude køre den. Når tallet er rigtigt, kan den køre fast, og du bruger tiden på de deals, den markerer.
Det afhænger af, hvor mange systemer agenten skal tale med. Jeg arbejder til fast pris, og en ugentlig prognose-agent på et CRM er en afgrænset opgave. Priserne står på min prisside.