Claude Opus 5.5 landede den 22. september 2026, og Anthropic lagde en tabel frem med ni benchmarks. Opus 5.5 fører på syv af dem. På de to sidste, AutomationBench og Terminal-Bench-Science, ligger GPT-6 Astra foran.
Lige under den tabel står der, med Anthropics egne ord, at "benchmark margins have become a less reliable guide to real-world differences". Og et par linjer længere nede: "In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest."
Det er en leverandør, der offentliggør sin egen scoretavle og i samme åndedrag beder dig om ikke at afgøre sagen ud fra den.
Så er spørgsmålet, hvad du i stedet skal afgøre den ud fra. Svaret ligger på den samme side, i de tolv kundecitater, Anthropic har valgt at tage med. Ikke ét af dem er en benchmarkscore.

Claude Opus 5.5 er landet, og prisen faldt
Start med prisen. Den er den eneste del af udgivelsen, der er et tal, du selv kan efterregne.
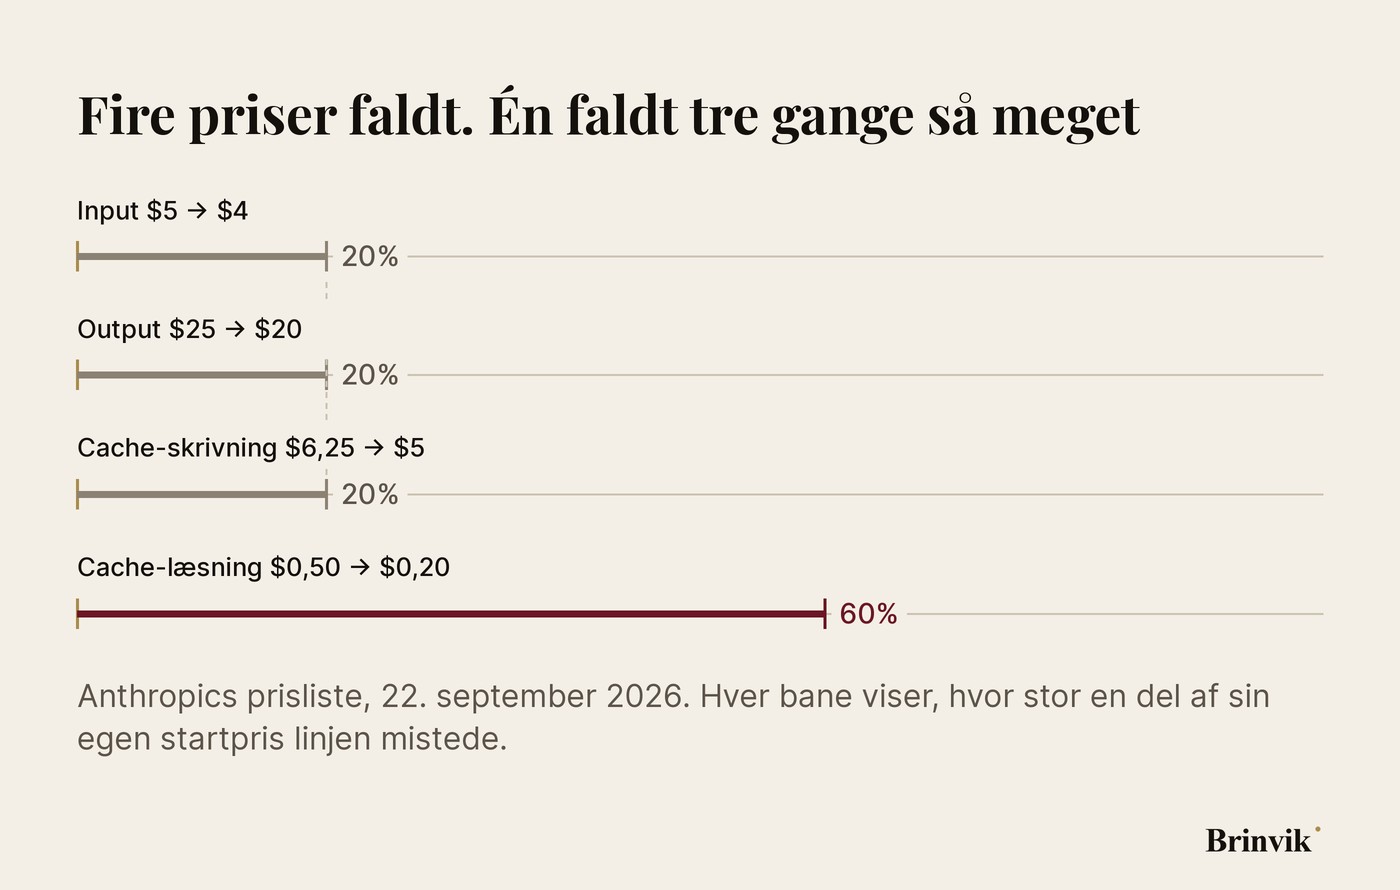
Claude Opus 5.5 koster 4 dollar per million input-tokens og 20 dollar per million output-tokens. Opus 5 kostede 5 og 25. Det er 20 procent ned på begge. Cache-skrivning i fem minutter falder fra 6,25 til 5 dollar, og i en time fra 10 til 8. Gennem Batch API er det halvt så meget, 2 og 10.
Den linje, der flytter sig mest, er den, færrest lægger mærke til. Cache-læsninger falder fra 0,50 til 0,20 dollar per million tokens. Det er 60 procent, altså et fald tre gange så stort som på hver af de fire andre linjer. Hvis du kører en agent, der læser det samme dokumentsæt igen og igen, er det den linje, der bestemmer, hvad du kommer til at betale, og den er ikke nævnt i en eneste overskrift.
Resten af de tørre tal: kontekstvinduet er på en million tokens, output op til 128.000 og modellens viden rækker frem til juni 2026 mod Opus 5's maj. Anthropic skriver, at den producerer output mere end 30 procent hurtigere end Opus 5. Der er også en "fast mode" i research preview på Claude API, som er op til 2,5 gange hurtigere endnu og koster det dobbelte, 8 og 40 dollar.
Anthropic samler det selv sådan her: "Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads." De to forbehold i den sætning er ikke pynt. "At default settings" betyder ved standardindstillingerne, og standardindstillingen blev ændret i den samme udgivelse: indsatsniveauet, som Anthropic kalder effort, står nu på medium, hvor det på Opus 5 stod på high. En del af de 40 procent er altså, at der er skruet ned for niveauet. Det er ikke noget, Anthropic skjuler. De skriver det på migrationssiden og beder dig sætte niveauet eksplicit og køre din egen måling igen.
Og "on typical workloads" er Anthropics typiske opgaver, ikke dine. Hvor meget af de 40 procent der bliver til noget hos dig, afhænger af, hvad du rent faktisk kører.
Og en ting mere, som betyder noget herhjemme. Opus 5.5 kan bruges under nul datalagring. Det er ikke nyt, og det skal siges præcist, for formuleringen er: "Like previous Opus models, Opus 5.5 is available with zero data retention." Reglerne har ikke flyttet sig. Det, der har flyttet sig, er, hvad du får inden for dem. Claude Fable 5.1 kræver 30 dages lagring og er ikke tilgængelig under nul datalagring, medmindre Anthropic udtrykkeligt godkender det. Lukker din databehandleraftale Fable 5.1 ude, er der i dag mere kapacitet inden for den ramme, du allerede har sat: Opus 5.5 ligger ifølge Anthropic på niveau med Fable 5.1 på de fleste områder. Få det bekræftet hos din leverandør i stedet for at gå ud fra det.
Claude Sonnet 5.5 og Claude Haiku 5.5 kommer "in coming weeks". Hold fast i den sætning. Den kommer igen.

Tabellen, som Anthropic selv tog forbehold for
Ni rækker. Terminal-Bench 4.0: 66,4 procent mod Opus 5's 52,3 og Fable 5.1's 55,8. FrontierCode v1.1: 54,4 mod 48,0. CursorBench 4.0: 57,8 mod 46,6. GDPval-AA v2.1: 1.846 Elo mod 1.708. Humanity's Last Exam med værktøjer: 67,7 mod 63,6. OSWorld 2.0: 81,8 mod 74,0. Chartography: 89,0 mod 83,4.
To rækker går den anden vej. På AutomationBench får GPT-6 Astra 41,4 procent mod Opus 5.5's 40,0. På Terminal-Bench-Science 0.1 er forskellen større: 64,6 mod 58,7.
Det er tal fra Anthropic om Anthropics egen model, og sådan skal de læses. Men bemærk, hvad Anthropic gør ved siden af dem, for det er det usædvanlige her. De viser forskellen frem og nedtoner den selv.
Læs den ene sætning igen: forskellene er blevet "a less reliable guide to real-world differences". Ingen siger, at tallene er forkerte. Påstanden handler om opløsningsevne. To modeller, der ligger på 66,4 og 55,8, ligger målbart langt fra hinanden. Spørgsmålet er, om forskellen også er der på dit arbejde, og der siger Anthropic selv nej: når de selv bruger modellerne, er afstanden mindre, end tabellen antyder.
Når en leverandør tager det forbehold på sin egen lanceringsside, er der sket noget, der ikke bliver sagt højt. Målingen er blevet dit arbejde, og ingen har sendt besked om, at den opgave er flyttet.
Det er også her, en typisk AI-implementering går galt, og sjældent på grund af modellen. Der blev bare aldrig truffet et valg, der kunne efterprøves. Nogen valgte det øverste navn i en tabel, og siden blev der ikke målt noget.

Tæl det, du betaler for
Så hvad gør de, der rent faktisk har målt?
Anthropic bringer tolv kundecitater på lanceringssiden. Gå dem igennem og se efter en benchmarkscore. Der er ingen. Her er seks af dem, og hver eneste tæller noget, virksomheden selv kunne tælle:
Quantium, ordret: "A complex coding task that previously took 38 prompts over four days came in at 11 prompts over three hours." To tal, ingen benchmark. Hvor mange gange nogen skrev til modellen, og hvor lang tid der gik.
Box: "Claude Opus 5.5 used a third of the tokens Opus 5 did, and its answers were 40% less verbose."
Rogo: "Claude Opus 5.5 beat Opus 5 at high effort on our BigFinance Bench with about 60% fewer output tokens."
Kiro: "Claude Opus 5.5 solved more than Opus 5 while making about 40% fewer calls."
GitHub: "Claude Opus 5.5 used among the fewest tokens and steps we measured."
Deloitte: "Claude Opus 5.5 caught 72% of known bugs in our code reviews to Opus 5's 56% at high effort."
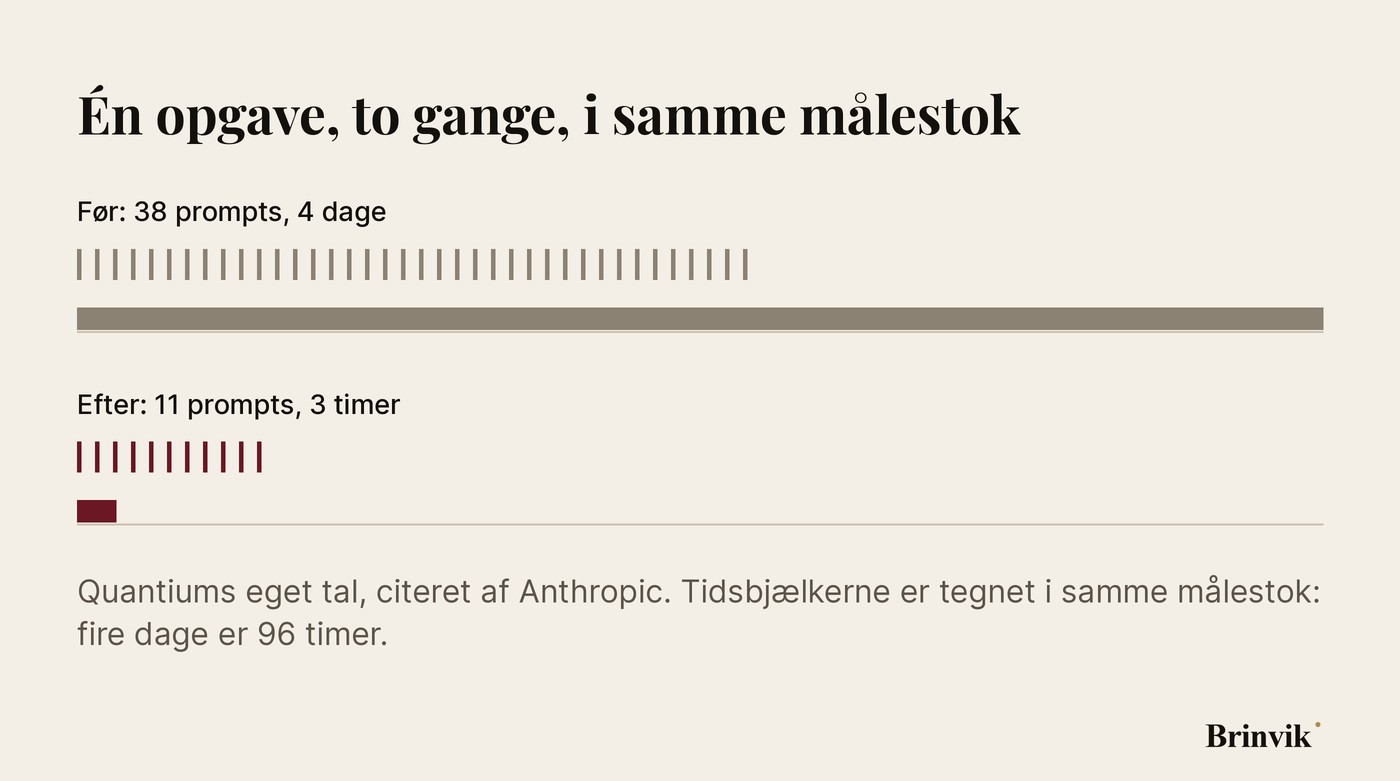
Prompts. Tid. Tokens. Kald. Trin. Fejl fanget. Det er valutaen, og de har ikke valgt den af høflighed. De har valgt den, fordi det er den eneste enhed, de selv kan tælle, og den eneste, der siger noget om deres eget arbejde.
Se på Quantium-tallet en gang til. 38 prompts over fire dage blev til 11 prompts over tre timer. Ingen skala, ingen procentforbedring. En opgave, der før tog fire arbejdsdage, er færdig inden frokost. Den forskel kan enhver i en dansk virksomhed med 40 ansatte se uden at forstå et eneste benchmark.
Og her er pointen, der gør det til andet end en observation: du kan tælle præcis de samme ting. Antal prompts, hvor lang tid det tog, antal gange, du sendte det tilbage. Det kræver ingen udvikler, ingen adgang til et API og ingen konto ud over den, du allerede har. Derfor er det de tal, kunderne kan citere offentligt, og derfor er de de rigtige tal for dig.

Din AI-strategi skal holde længere end modellen
Her kommer sætningen igen. Sonnet 5.5 og Haiku 5.5 kommer om få uger.
Kig så på, hvad der skete med Opus 5. Den udkom den 24. juli 2026. I dag, den 22. september, står der Legacy øverst på dens side hos Anthropic, og under status står der "Active (legacy)". Anthropic definerer selv Legacy sådan: modellen får ikke længere opdateringer og kan blive udfaset senere. På siden står også: "Although Claude Opus 5 is still available, you should consider migrating to Claude Opus 5.5 for improved performance."
Opus 5 er hverken udfaset eller lukket ned. Den kører, den er understøttet, og den har en udløbsdato, der tidligst er den 24. juli 2027. Men som den nyeste Opus-model holdt den i tres dage.
Tres dage er kortere end et indkøbsforløb i de fleste virksomheder. Det er kortere end en pilotperiode. Det er væsentligt kortere end den slags leverandørsammenligning, hvor du stiller tre modeller op mod hinanden og bruger seks uger på at finde ud af, hvilken der er bedst.
Det er dér, den almindelige fremgangsmåde falder fra hinanden. En sammenligning, der tager seks uger, afleverer sit svar, efter at det, den sammenlignede, er skiftet ud. Du ender med et grundigt dokument om et modelfelt, der ikke længere ser sådan ud, og fordi arbejdet var dyrt, bliver konklusionen stående i et år.
Det samme gælder de instruktioner, du selv har skrevet. Har du en CLAUDE.md-fil eller et sæt skills liggende, er de skrevet til den model, der var nyest dengang. Kommandoen /claude-api prompt-audit i Claude Code holder dine egne prompts, skills og instruktionsfiler op imod en målmodel, du navngiver, for eksempel Opus 5.5. Den ændrer ikke noget af sig selv: du får en rapport med fil og linjenummer på hvert sted, der er skrevet til en ældre model, og et forslag til, hvad der skal laves om. Det rydder op i det, du selv har skrevet. Den anden halvdel er målingen af dit eget arbejde.
Den eneste måling, der er noget værd nu, er den, du kan køre igen på en eftermiddag. Grundigheden skal ikke ned. Det, du måler på, skal skiftes ud. Spørgsmålet er ikke længere, hvilken model der er bedst, men hvad dine egne ti opgaver koster i prompts og timer lige nu, så du har noget at holde den næste udgivelse op imod.
En AI-strategi, der er bygget op om ét modelnavn, holder til næste lancering. En AI-strategi, der er bygget op om en måling, holder på tværs af lanceringerne.

Ti opgaver, tre tal, én eftermiddag
Her er arket. Det er hele redskabet, og det tager en eftermiddag.
Vælg ti opgaver, du faktisk kørte sidste måned. Ikke ti opgaver, du forestiller dig. Ti, du kan finde igen: et tilbud, du skrev, et datasæt, du ryddede op i, en mailtråd, du opsummerede, en kontrakt, du læste igennem.
Skriv tre tal ved hver:
- Hvor mange prompts det tog, før du var færdig og kunne bruge svaret.
- Hvor lang tid der gik, fra du begyndte, til du var færdig.
- Hvor mange gange du sendte det tilbage, fordi det første svar ikke var godt nok.
Skriv dagens dato på arket. Det er alt.
Jeg har valgt de tre tal, fordi du kan udfylde dem, uanset hvad du kører. Du behøver ikke at stå for integrationen. Du behøver ikke at kunne se, hvilken model der er under værktøjet, eller hvilket effort-niveau den kører på. Den, der sidder og venter på svaret, kan tælle prompts, tid og tilbageløb udefra. Af alle de målinger, branchen diskuterer, er det den eneste, der ikke kræver adgang til noget som helst.
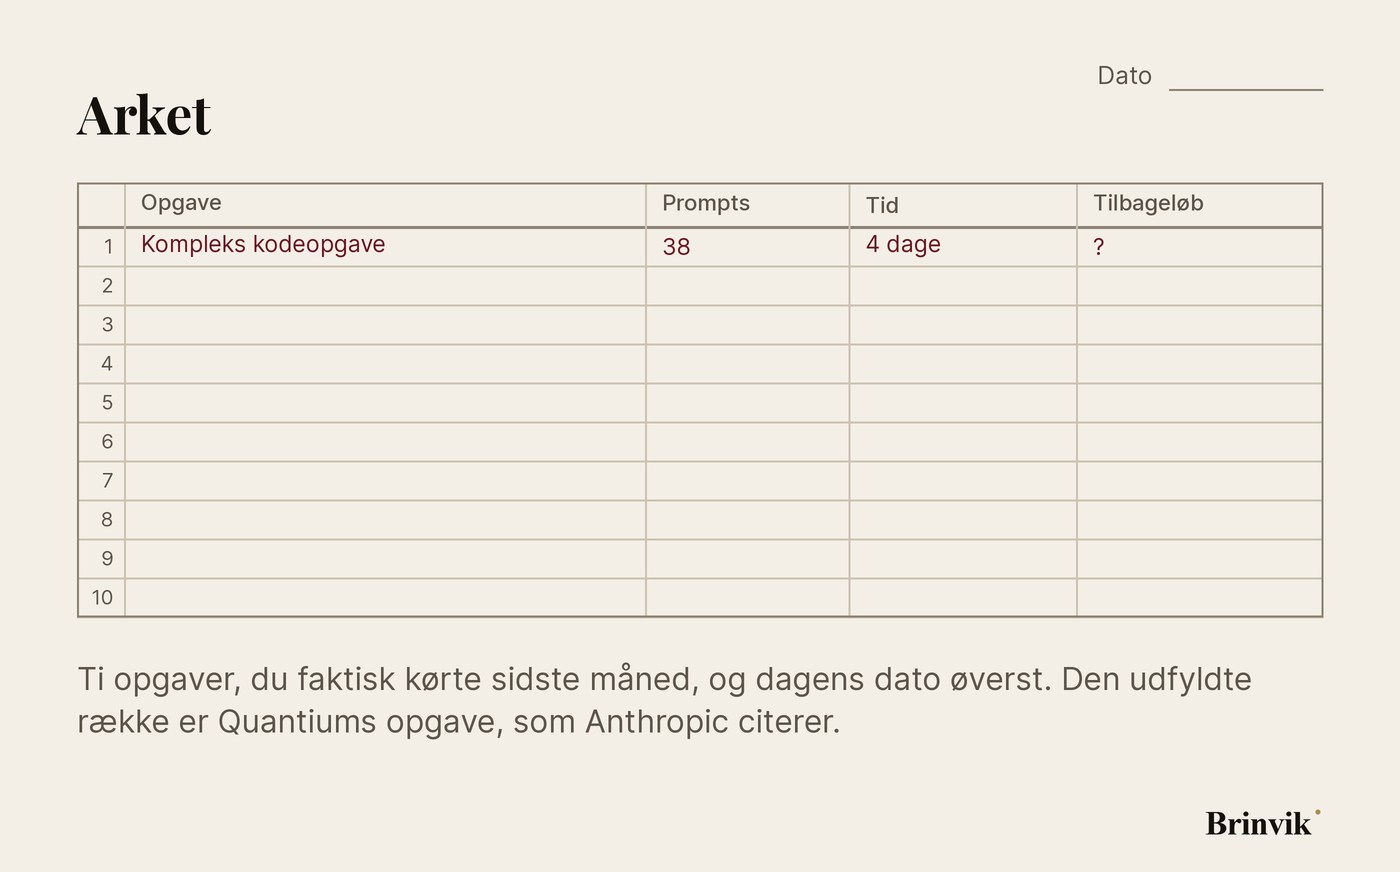
Lån Quantiums opgave, så ser en udfyldt række sådan ud: 38 prompts, fire dage, ukendt antal tilbageløb, dateret før opgraderingen. Og den samme opgave efter: 11 prompts, tre timer. Det er hele analysen. Der er ikke en model i den.
Når Sonnet 5.5 lander om få uger, tager du arket frem og kører de samme ti opgaver igen. Det tager en eftermiddag mere. Forskellen mellem de to ark er den eneste sammenligning, der handler om dit arbejde.
Det svære er ikke at tælle. Det svære er at vide, om tallene, du får ud, er gode. Elleve prompts på tre timer siger ingenting i sig selv, og du har ikke andet at holde det op imod end leverandørens egen side. Som AI-konsulent i København laver jeg netop den del for danske virksomheder. Jeg sætter målingen op, så den rammer det arbejde, der faktisk koster noget, og læser resultatet sammen med dig, så tallet bliver til en beslutning. Det er også det, der adskiller en rigtig AI-audit fra en rundvisning i værktøjer.
Hvis du vil have nogen til at holde øje med det løbende, i stedet for at tage den samme diskussion ved hver eneste lancering, er det en fast AI-aftale på abonnement, der passer til det. Og vil du se, hvad den slags målinger gjorde ved en regning i praksis, har jeg skrevet om det her: da en modelopgradering gjorde arbejdet 36 procent dyrere.
Til sidst det, der ikke stod nogen steder i materialet. Hvert eneste tal i udgivelsen sammenligner Opus 5.5 med Opus 5, med Fable 5.1 eller med GPT-6 Astra. Ikke ét af dem sammenligner den med det, du kører i dag, for der er ingen hos Anthropic, der ved, hvad det er. Deres side mangler ingenting. Den måling kunne aldrig have været nogen andens opgave end din.
FAQ
Ofte stillede spørgsmål
4 dollar per million input-tokens og 20 dollar per million output-tokens. Opus 5 kostede 5 og 25, så det er 20 procent ned på begge. Cache-læsninger falder fra 0,50 til 0,20 dollar, altså 60 procent, og gennem Batch API er prisen halveret igen. Tallene står på Anthropics prisliste, læst den 22. september 2026.
Nej. Opus 5 kører stadig og er understøttet. Anthropic har markeret den som Legacy, hvilket efter deres egen definition betyder, at modellen ikke længere får opdateringer og kan blive udfaset senere, og udløbsdatoen er tidligst den 24. juli 2027. Du behøver ikke at skifte i dag, men Anthropic anbefaler det.
Opus 5.5 fører på syv af Anthropics egne ni benchmarks. Men Anthropic skriver på den samme side, at forskellene er blevet en mindre pålidelig rettesnor for, hvordan modellerne adskiller sig i praksis, og at afstanden til Claude Fable 5.1 er mindre, end tallene antyder. Vil du vide, hvor meget bedre den er på dit arbejde, er du nødt til at måle det selv.
Indsatsniveauet, som Anthropic kalder effort, stod på high på Opus 5 og står på medium på Opus 5.5. Sender du en prompt uden at sætte niveauet, tænker modellen altså mindre end før. Anthropic skriver det på migrationssiden og beder dig sætte niveauet eksplicit og køre din egen måling igen.
Ja, og det er ikke en ændring. Anthropic skriver, at Opus 5.5 ligesom tidligere Opus-modeller er tilgængelig med nul datalagring. Til sammenligning kræver Claude Fable 5.1 30 dages lagring og er ikke tilgængelig under nul datalagring, medmindre Anthropic udtrykkeligt godkender det. Få det bekræftet for din egen aftale hos din leverandør.
Vælg ti opgaver, du faktisk kørte sidste måned, og skriv tre tal ved hver: hvor mange prompts det tog, før du kunne bruge svaret, hvor lang tid der gik og hvor mange gange du sendte det tilbage. Sæt dagens dato på arket. Når den næste model lander, kører du de samme ti opgaver igen og sammenligner de to ark. Det kræver hverken en udvikler eller adgang til et API.
Anthropic skriver "in coming weeks" og har ikke sat en dato. Begge modeller får ifølge Anthropic mange af de samme forbedringer i ydelse, effektivitet og sikkerhed som Opus 5.5.
Kilder
- Anthropic: Introducing Claude Opus 5.5
- Hvad der er nyt i Claude Opus 5.5, med de fire ændringer, der bryder bagudkompatibiliteten, og standardindstillingen
- Modelsiden for Claude Opus 5.5, med priser, kontekstvindue og datoer
- Modelsiden for Claude Opus 5, hvor der nu står Legacy
- Anthropics udfasningsside, med status og udløbsdato for hver model
- Claude Platform release notes, 22. september 2026
- Anthropics prisside
- Brinvik: 36 % dyrere på en bedre model, 9. september