TL;DR: Sonnet 5.5 koster det samme som Sonnet 5, men Anthropic opremser fem ændringer, der kan give kode skrevet til Sonnet 5 en 400-fejl, og én, der slet ikke giver en fejl. De fem fanger du i en test eller i en log. Den sjette advarer ingen: når en agent kalder værktøjer og streamer svaret til et chatvindue, forsvinder de længere noter mellem værktøjskaldene, og en sælger kigger på en spinner, mens kunden venter. Én indstilling retter det, og tjekket herunder viser, hvilke af ændringerne der rammer din request.
Tjekket starter med en salgsassistent, der i dag kører på Claude Sonnet 5, og det er netop den, der bliver tavs. Anthropic lancerede Claude Sonnet 5.5 den 28. september 2026, og samme dag fik jeg Claude Code til at bygge tjekket ud fra Anthropics egen migreringsguide.

Skal du gøre noget ved Claude Sonnet 5.5?
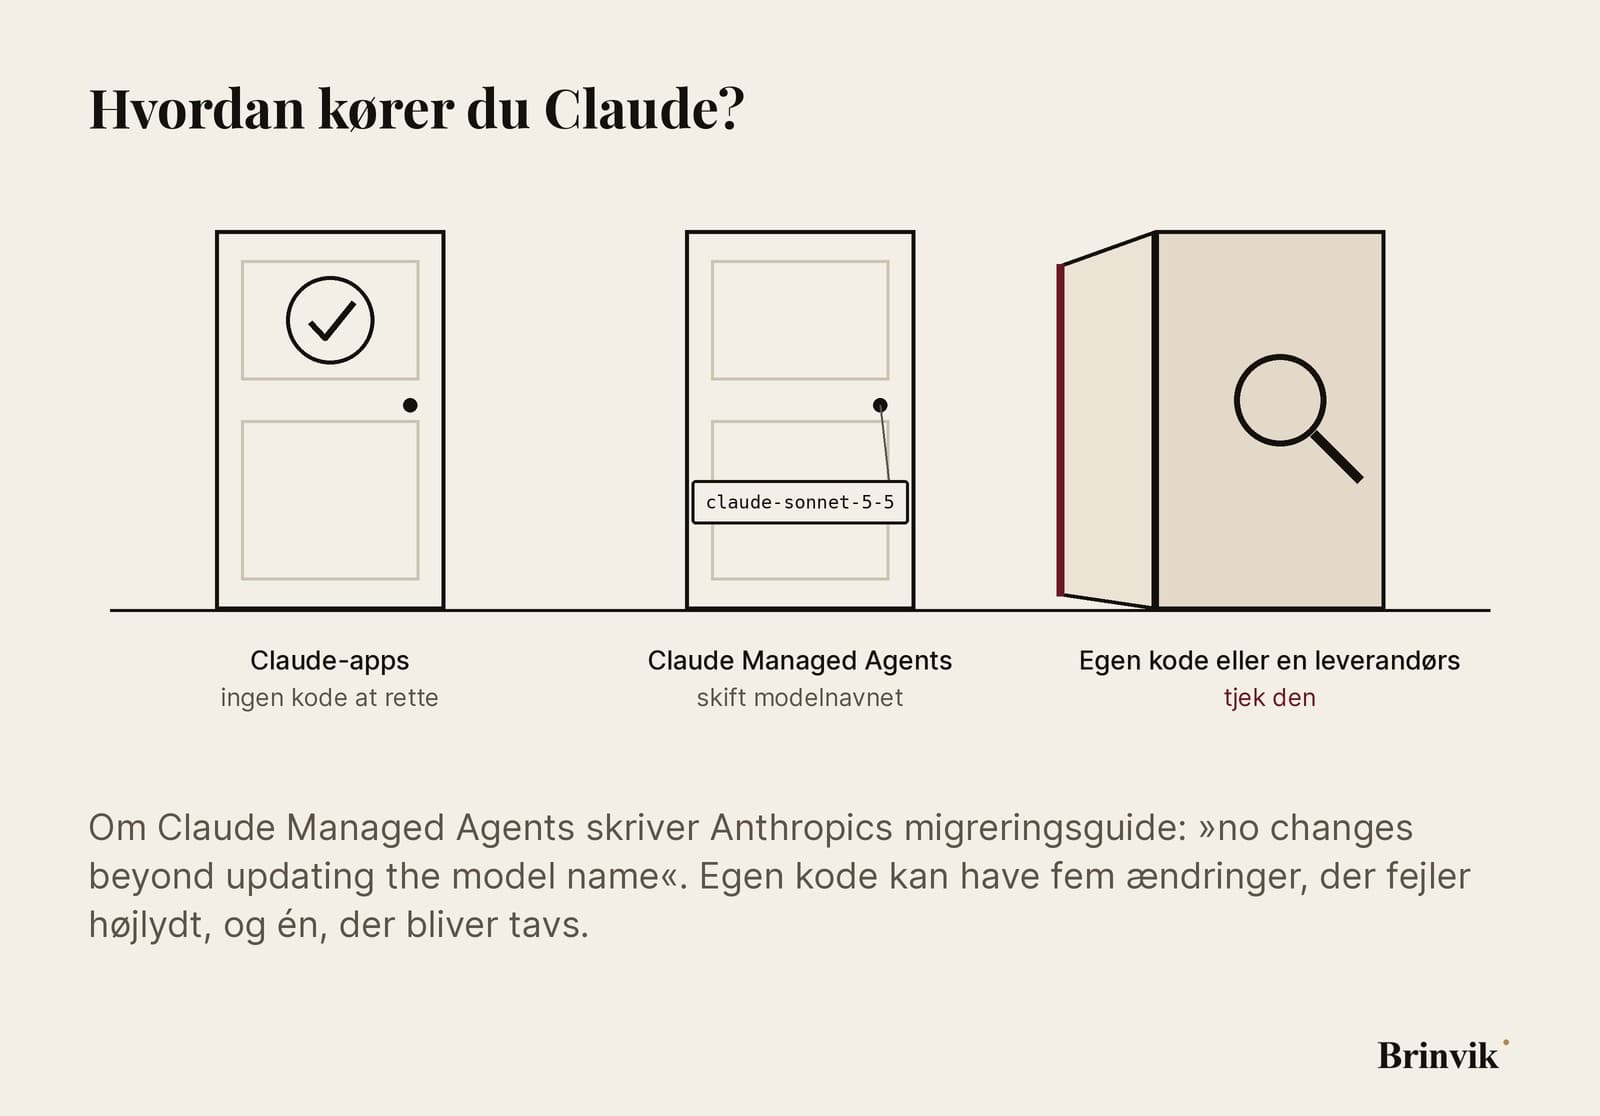
Det afhænger af, hvordan du kører Claude.
- Bruger du kun Claude-apps, handler Anthropics migreringsguide ikke om dig. Den dækker kode, der kalder API'et.
- Bruger du Claude Managed Agents, skriver Anthropic i migreringsguiden, at der ikke skal ændres andet end modelnavnet.
- Kalder din egen kode eller en leverandørs kode Claude API'et, så læs videre. Det er her, skiftet kan gå galt.
Den sidste gruppe er større, end man skulle tro. En supportagent, en agent til leadscoring eller en salgsassistent i CRM'et er tit bygget af en leverandør eller en kollega. Den kører på et modelnavn, som nogen en dag skifter.

Hvorfor du skifter alligevel
Prisen er den samme som for Sonnet 5: 2 dollar pr. million input-tokens og 10 dollar pr. million output-tokens. Ifølge Anthropics egen måling skriver Sonnet 5.5 sine svar mere end 30 procent hurtigere end Sonnet 5. Den bruger typisk færre tokens på det samme arbejde, og i Anthropics test koster den op til 30 procent mindre pr. opgave.
Kunderne på lanceringssiden peger samme vej. Zendesk skriver, at sager blev behandlet 20 procent hurtigere end med de Claude-modeller, de kører i produktion i dag. Det er Zendesks eget tal fra deres egne supportsager.
Anthropic skriver også, hvor grænsen går. Sonnet 5.5 er stærkest til afgrænsede hverdagsopgaver, fejlrettelser og dokumenter, mens Opus 5.5 ifølge Anthropics egne og eksterne testere stadig er klart stærkere til komplekst, åbent arbejde, der kræver vedvarende dømmekraft.
Jeg ville selv skifte. Det er ikke meget arbejde, når du ved, hvor det ligger.

Fire AI-agenter, tjekket
Tjekket har fire eksempler, der ligner agenter, en kommerciel afdeling faktisk kører. Tre er skrevet til Sonnet 5, ét til Sonnet 4.5. Bag dem ligger 17 regler. De dækker fire af de fem ændringer, Anthropic opremser i forhold til Sonnet 5, og den ene, der ikke giver fejl. Den femte, ændret historik, kan ikke ses i én request. Derudover tjekker reglerne modelnavnet og de ældre ændringer, migreringsguiden nævner.
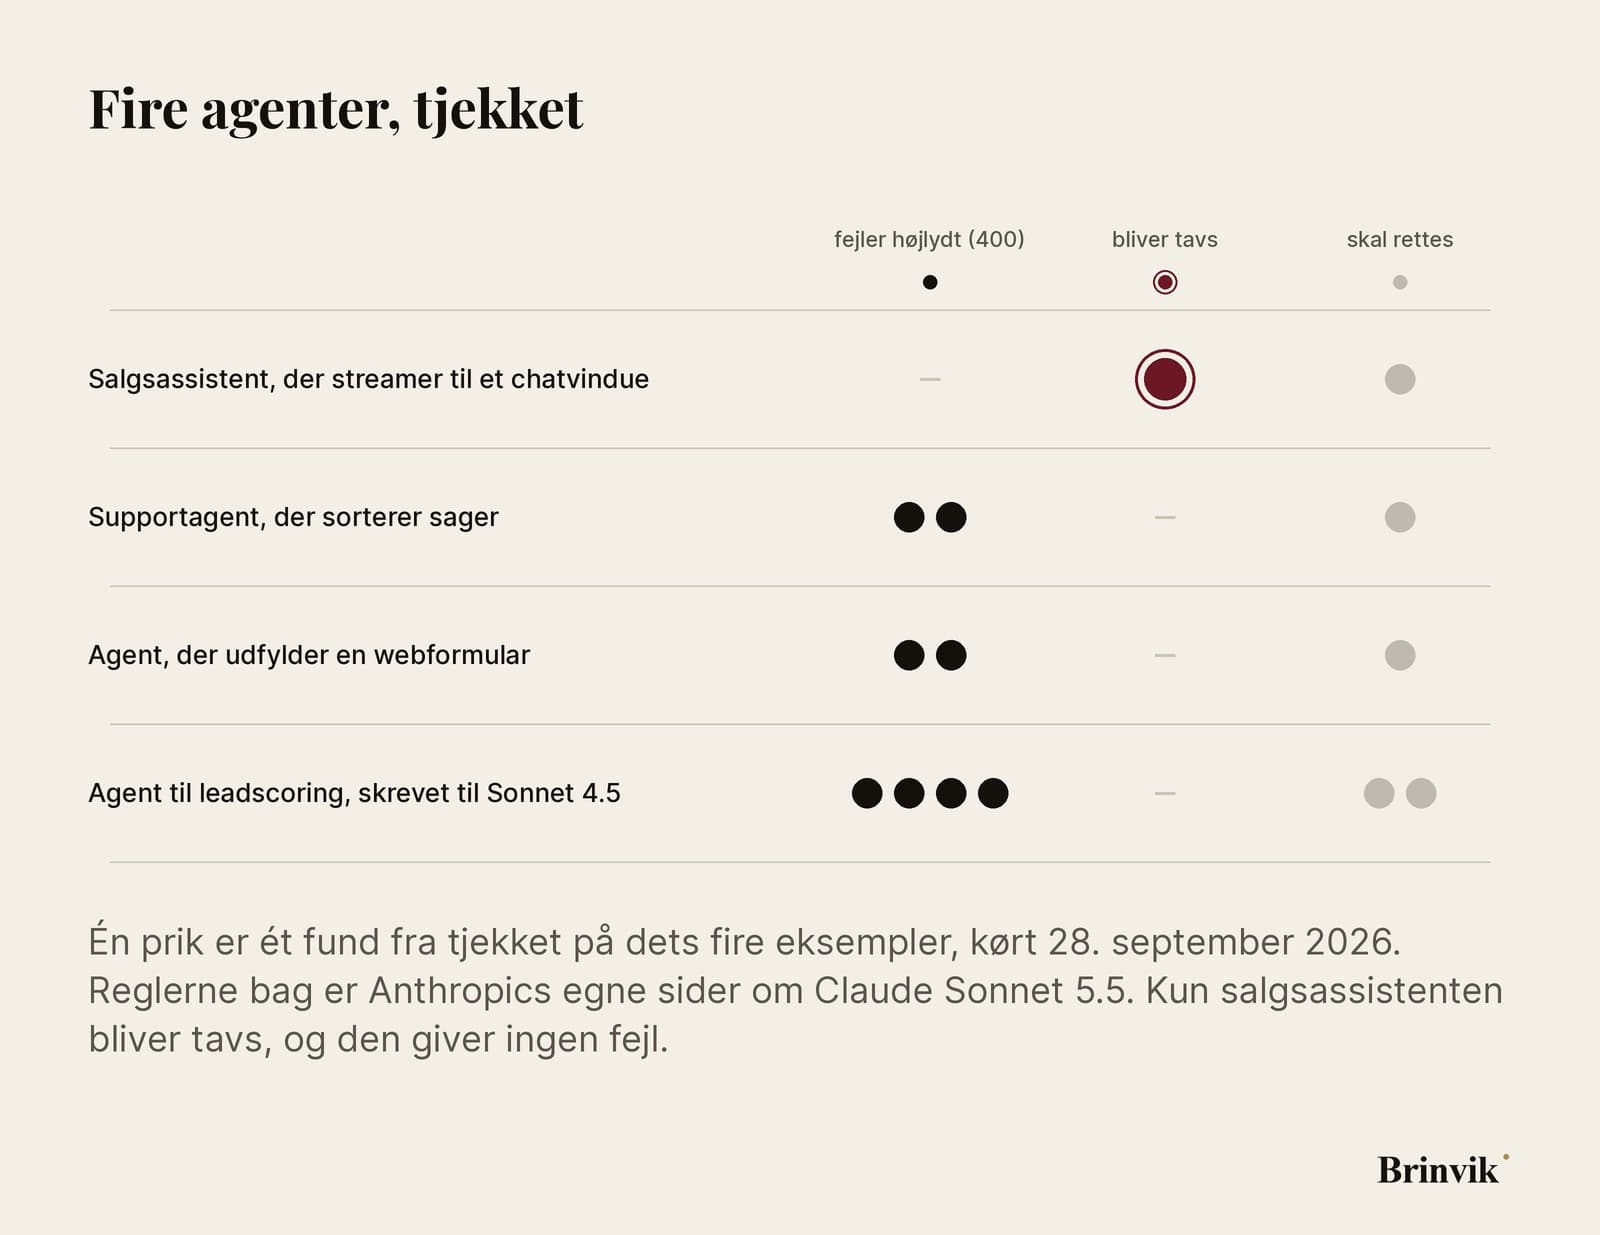
- Salgsassistenten, der streamer til et chatvindue, får ingen 400-fejl. Den bliver tavs. Mere om den nedenfor.
- Supportagenten, der sorterer sager, fejler højlydt to gange. Den slår thinking fra med
disabled, som Sonnet 5.5 afviser, og den tvinger et bestemt værktøjskald, som Sonnet 5.5 heller ikke tager imod. - Agenten, der udfylder en webformular, fejler højlydt to gange: den gamle version af computer use og en beta-header, der ikke må stå sammen med det nye toolset.
- Agenten til leadscoring, skrevet til Sonnet 4.5, fejler højlydt fire gange: et thinking-budget, en
temperature-værdi, et forudfyldt svar og et formatfelt, der er flyttet.
Hver rettet request tjekkes igen og består uden en eneste fejl. Men læg mærke til supportagenten. Når disabled bliver til between_tools, kommer noterne mellem værktøjskaldene tilbage, så supportagenten ikke bliver tavs. Det bliver salgsassistenten derimod, for den har slet ikke et thinking-felt. Supportagenten fejler højlydt første dag og bliver rettet. Salgsassistenten går i drift, og det er en sælger med en kunde foran sig, der opdager, at den er blevet tavs.

Den agent, der bliver tavs
Forestil dig salgsassistenten i brug. En sælger skriver: "Jeg har et møde med Nordhavn Fragt om ti minutter. Hvad er åbent?" På Sonnet 5 svarer assistenten undervejs. Den slår firmaet op i CRM'et, henter de åbne handler og siger, hvad den gør, mens den gør det.
På Sonnet 5.5 kører de samme værktøjskald. Men de længere noter mellem dem kommer nu i thinking-blokke (den del af svaret, hvor modellen tænker), og med standardindstillingen er teksten i dem tom. Korte noter kommer stadig igennem. Anthropic skriver selv, at en app, der streamer den tekst til sine brugere, bliver tavs mellem værktøjskaldene.
Der er ingen fejlmeddelelse og intet rødt i en log. Udvikleren ser ingenting, fordi intet fejler. Den første, der opdager det, er sælgeren, der kigger på en spinner, mens kunden venter.
Du kan se det på forhånd med ét blik på requesten. Din agent bliver tavs, hvis den kalder værktøjer og streamer svaret til en person, og requesten hverken sætter display i thinking-feltet til summarized eller updates eller bruger between_tools. Har en leverandør bygget agenten, er det de tre spørgsmål, du sender til leverandøren.
Du retter det med én indstilling. Er det en chat, dine kunder læser, så sæt display til updates med den beta-header, Anthropic angiver. Skal agenten ikke tænke, før den svarer, kan du i stedet bruge between_tools. I begge tilfælde ser brugeren kun noterne og ikke modellens overvejelser. Undgå summarized her: den sender også resuméer af overvejelserne med, og ifølge Anthropic kan de ikke skelnes fra noterne.

Tre måder at tjekke din Claude-integration på
Hvilken metode du skal bruge, afhænger af, hvor meget adgang du har.
- Kun en browser: tjekket i starten af artiklen. Det læser én request og intet andet. Du kan sende linket til den, der ejer agenten.
- Læseadgang til koden: en prompt til Claude Code, som finder alle steder, hvor koden kalder Claude, og oplister, hvilke ændringer der rammer hvert sted. Den ændrer ingenting.
- Lov til at ændre koden: Anthropics egen skill i Claude Code,
/claude-api migrate. Den skifter modelnavnet og retter parametrene i hele kodebasen, men spørger først, hvor meget den må ændre. Den er det bedste valg, når du har den adgang.
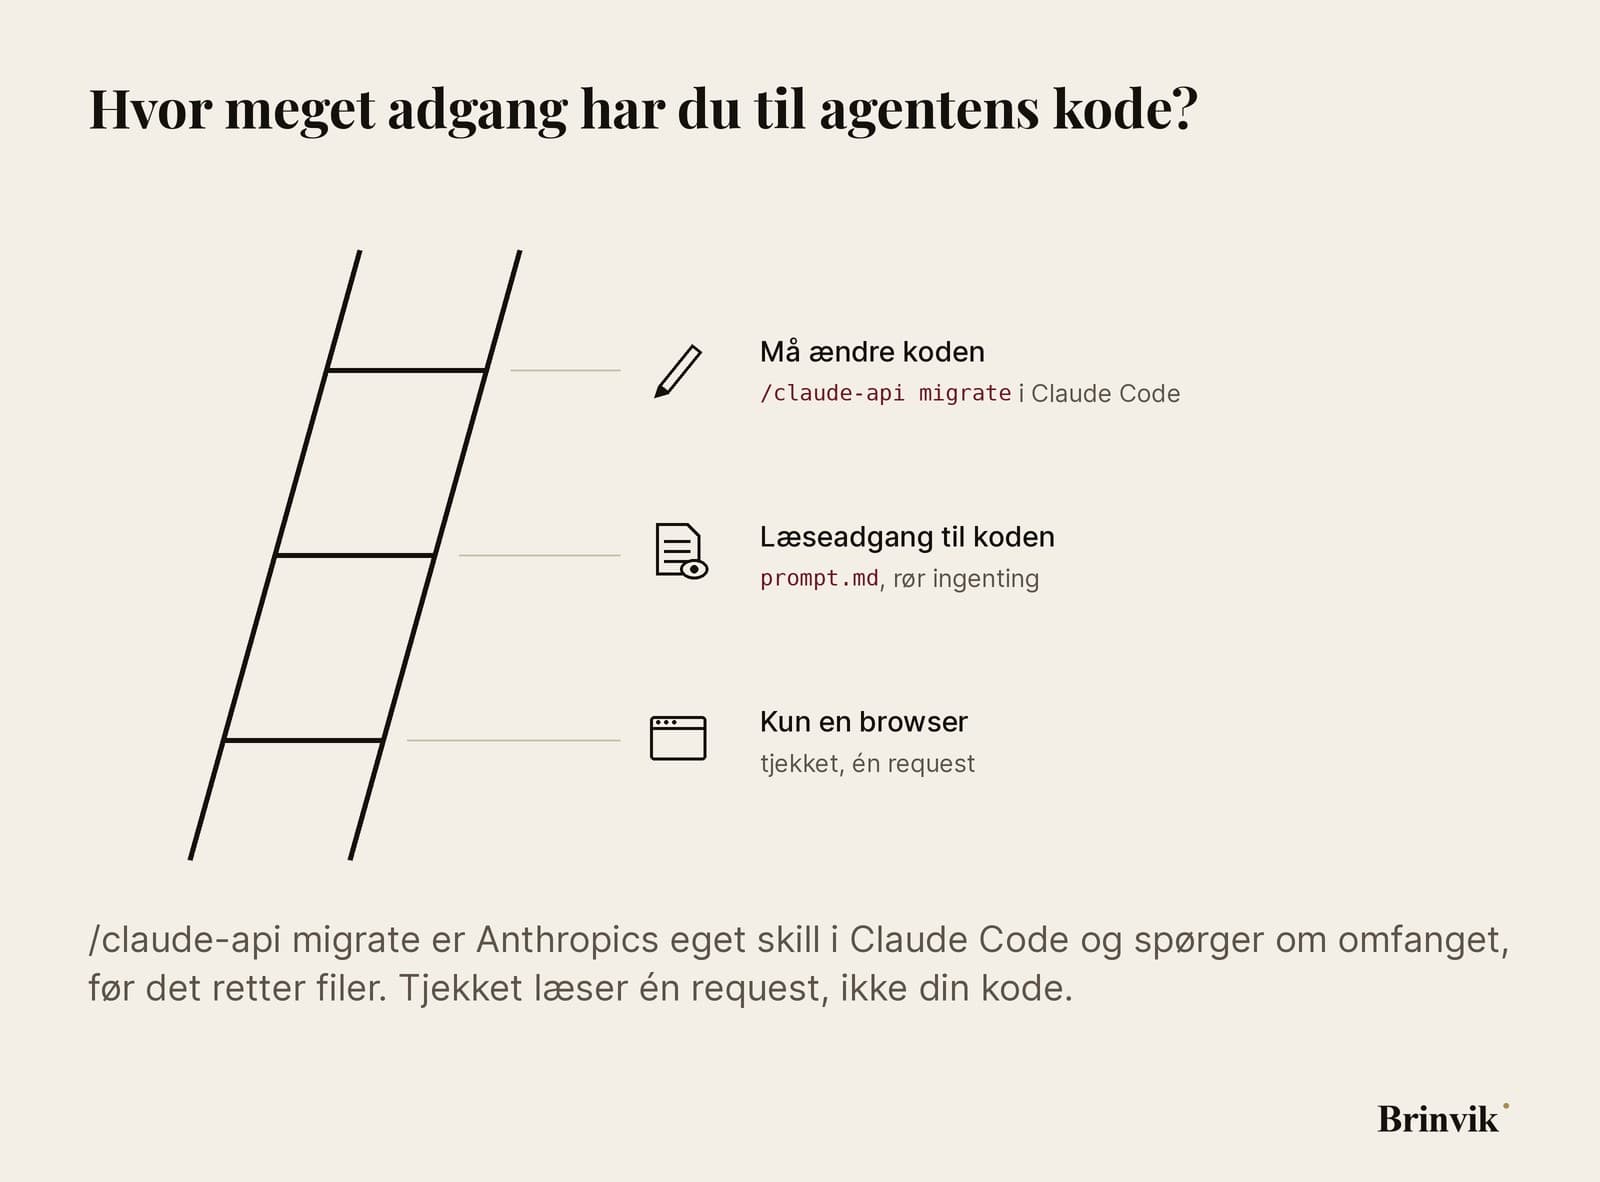
Tjekket har grænser, og de står på siden. Det læser én request og ikke din kode. Læser koden svaret som content[0].text, går den i stykker, når et svar begynder med en thinking-blok, og det kan tjekket ikke se. Det kan heller ikke se, om koden ændrer tidligere historik, før den sender samtalen igen. På konti oprettet den 31. august 2026 eller senere giver det en 400-fejl at sende en thinking-blok igen efter ændret historik. Reglerne i tjekket er dem, der gjaldt den 28. september 2026.
Reglerne kan du også tage med dig. swap-check.js er den samme regelmotor som en fil, du kan lægge i en testsuite.

Det gør jeg, når en kunde får en ny model
Som AI-konsulent ser jeg den samme situation igen og igen. Agenten kører, men den, der ejer den, ejer ikke koden. Den er købt hos en leverandør, eller en kollega har bygget den uden en udvikler. Det skrev jeg om i Alle kan bygge en AI-agent nu. Den person kan ikke køre /claude-api migrate og ved ikke, hvilke ændringer der rammer agenten.
Det er det, jeg gør på en fast aftale som ekstern AI-lead. Når Anthropic lancerer en ny model, gennemgår jeg dine AI-agenter, retter det, der fejler højlydt, finder den agent, der bliver tavs, og tester skiftet med de mennesker, der bruger dem, før det går i drift.
Med ét blik på requesten finder du den tavse agent, før sælgeren gør det.
FAQ
Ofte stillede spørgsmål
Det samme som Sonnet 5: 2 dollar pr. million input-tokens, 10 dollar pr. million output-tokens og 0,20 dollar pr. million tokens for læsning fra cache. Anthropic skriver, at modellen typisk bruger færre tokens på det samme arbejde, og at den i Anthropics egne test koster op til 30 procent mindre pr. opgave.
Prisen er den samme, og ifølge Anthropics egen måling skriver Sonnet 5.5 sine svar mere end 30 procent hurtigere. Kalder din egen kode API'et, så tjek den først for de fem ændringer, der giver en 400-fejl, og for den ene, der får en agent til at blive tavs uden at melde fejl.
Anthropic opremser flere ændringer, der giver en 400-fejl. Din kode rammes, hvis den slår thinking fra med disabled i stedet for between_tools, tvinger et værktøjskald med tool_choice any eller tool eller bruger computer_20251124 på Claude API'et eller Google Cloud. Migreringsguiden nævner også en temperature-værdi, der ikke står på standard. Tjekket i starten af artiklen viser, hvilke af dem der rammer din request.
De længere noter, modellen skriver mellem værktøjskald, kommer nu i thinking-blokke, og med standardindstillingen er teksten i dem tom. Sæt display til updates med den beta-header, Anthropic angiver, eller brug between_tools. Undgå summarized i en chat, kunderne læser: den viser også resuméer af modellens overvejelser.
Ja. Ifølge Anthropics release notes er modellen tilgængelig på Claude API'et, Amazon Bedrock, Claude Platform on AWS, Google Cloud og Microsoft Foundry. På Bedrock hedder den anthropic.claude-sonnet-5-5.
Ja. Anthropic skriver, at Sonnet 5.5, ligesom Opus 5.5 og Sonnet 5, fås med zero data retention.
Anthropic skriver, at Sonnet 5.5 er stærkest til afgrænsede hverdagsopgaver, fejlrettelser og dokumenter, mens Opus 5.5 er klart stærkere til komplekst, åbent arbejde, der kræver vedvarende dømmekraft. Opus 5.5 koster 4 dollar pr. million input-tokens og 20 dollar pr. million output-tokens.